M2 收官之后,我给自己布置了一个轻量任务:不看书,把 GPTModel 用 A4 纸默写一遍。
为什么默写?因为“看懂”和“写出”是两回事。读代码的时候是再认,默写的时候是回忆——只有回忆得出来,才算真的学到手了。GPTModel 又是我探索整个 LLM 的主干底座,值得反复默到肌肉记忆。
四张纸的内容
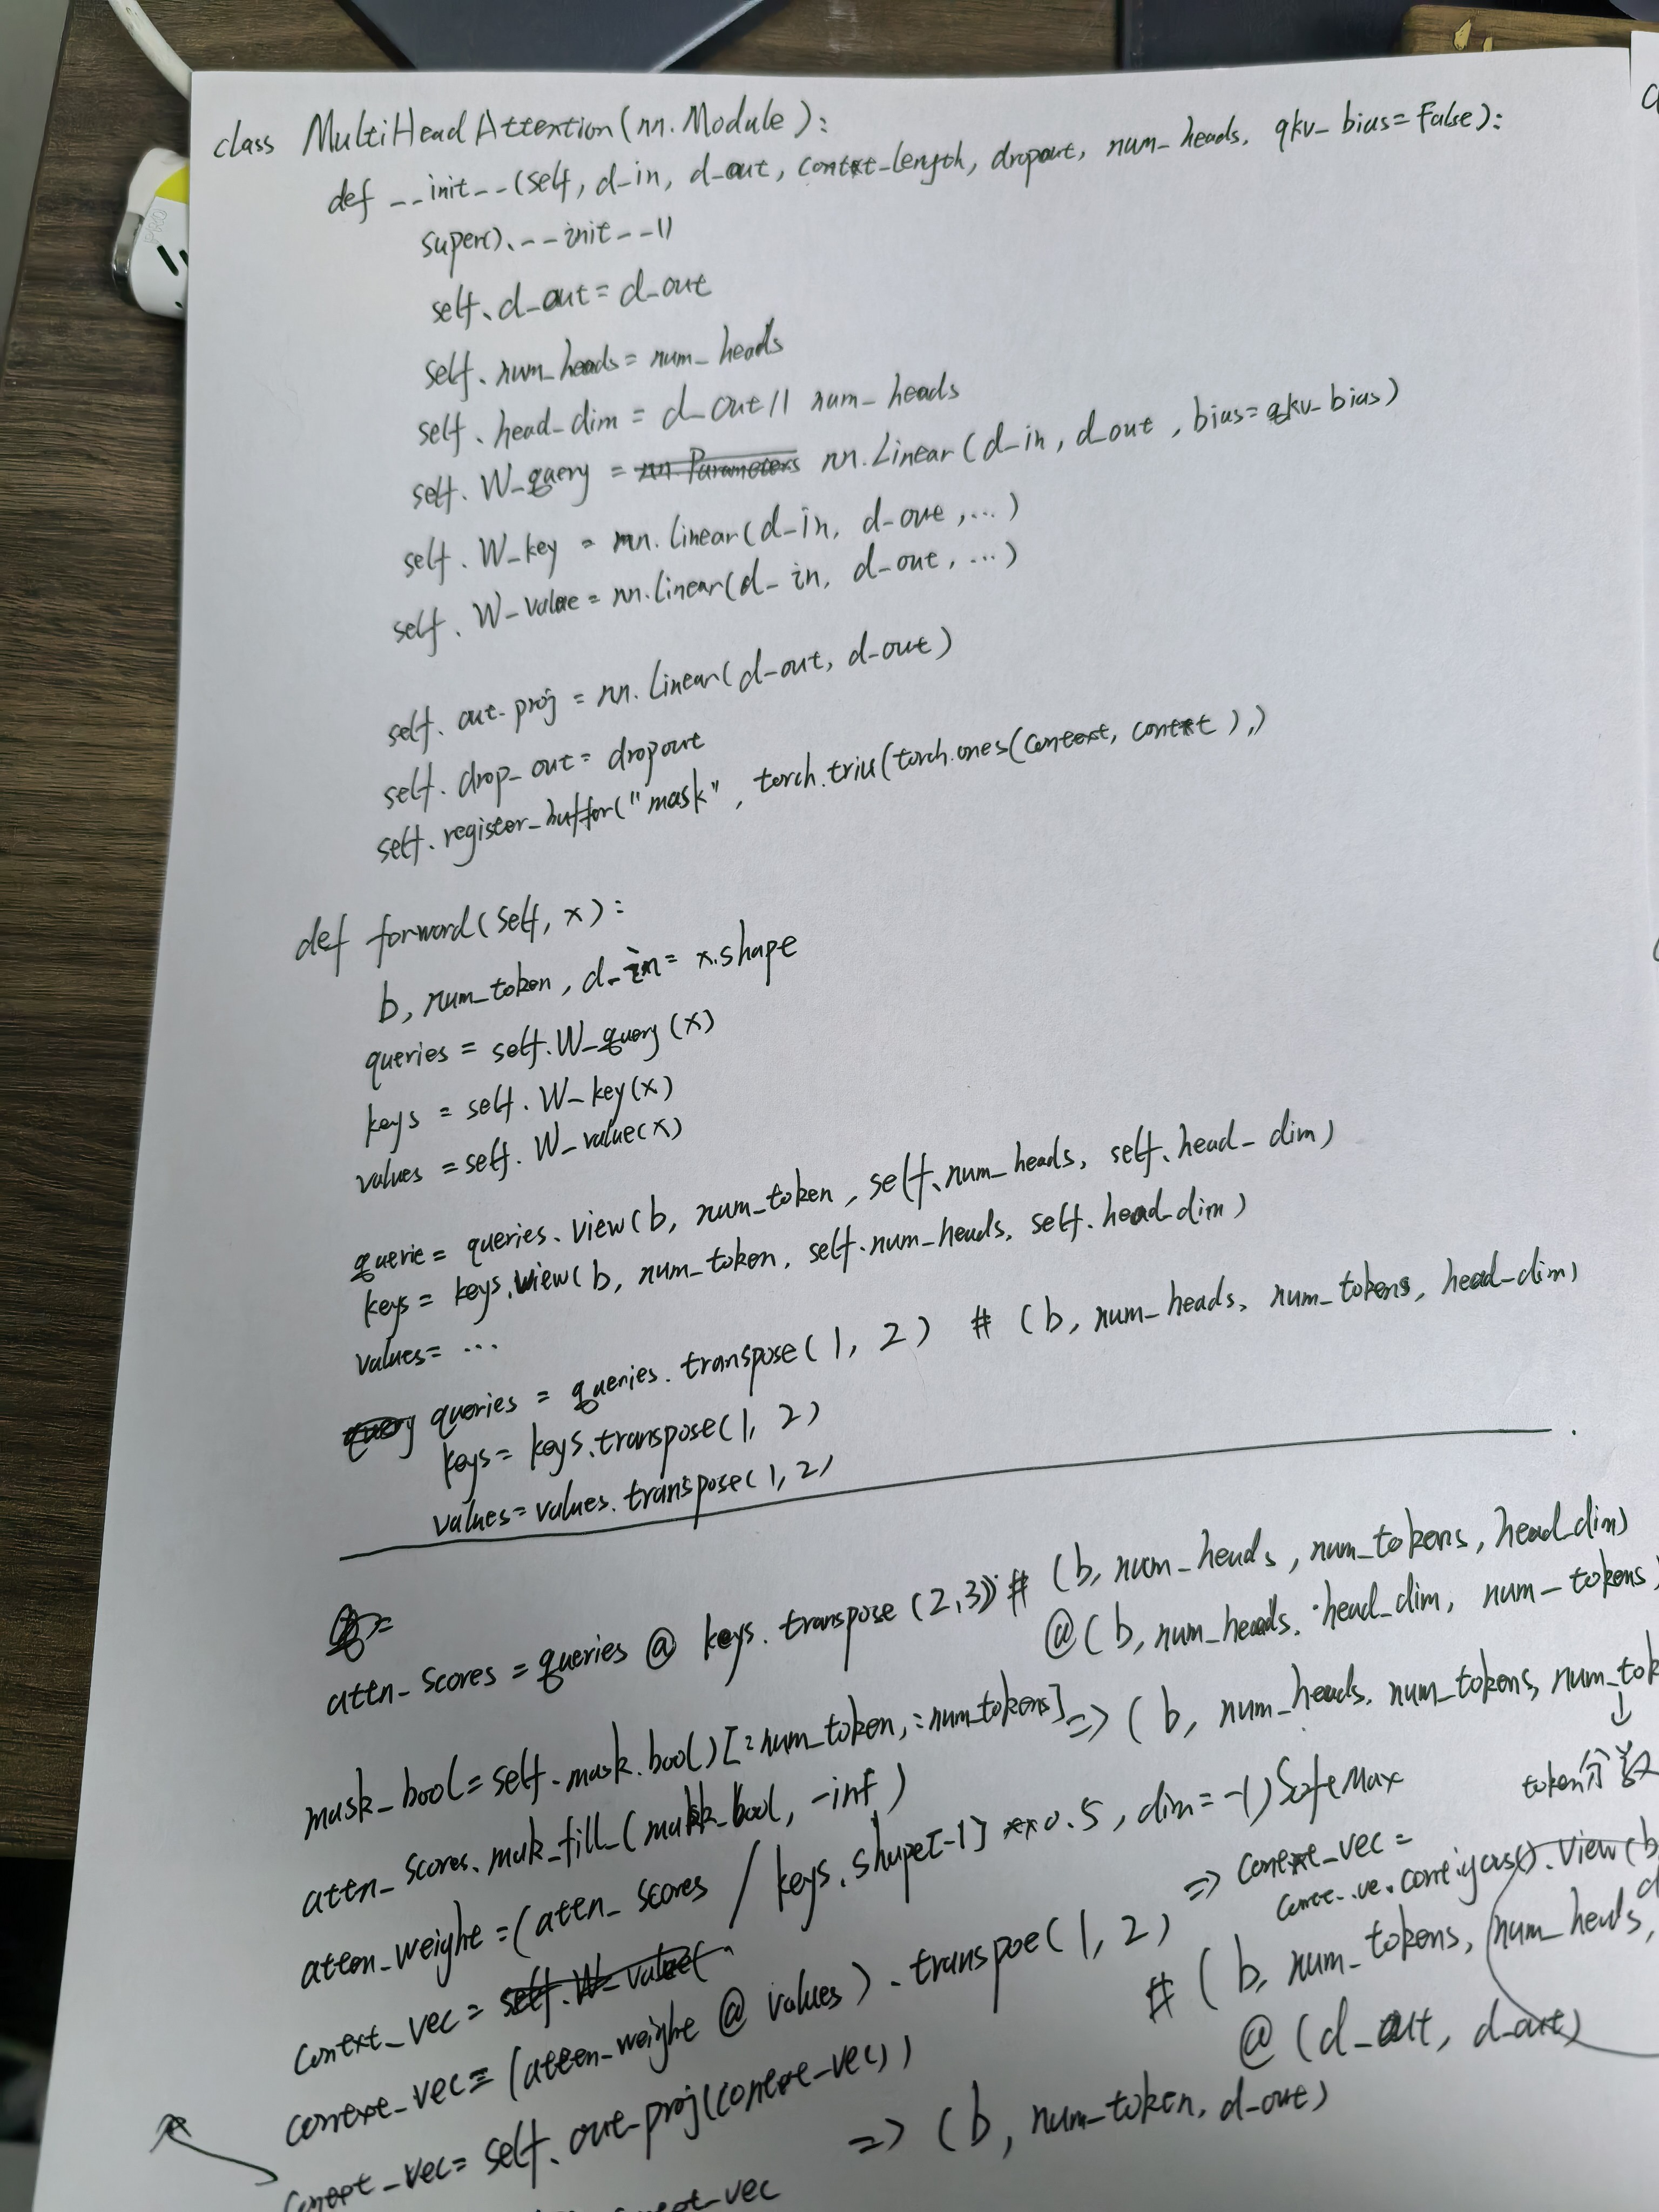
第一张:MultiHeadAttention。 init 里的 qkv 投影、out_proj、dropout、mask 的 register_buffer;forward 里的 view/transpose、attn_scores、因果掩码、softmax、context_vec 的变形。最重要的是,我顺手把每一段的 shape 都标了出来——shape 能对上,说明数据流是真的理解了。
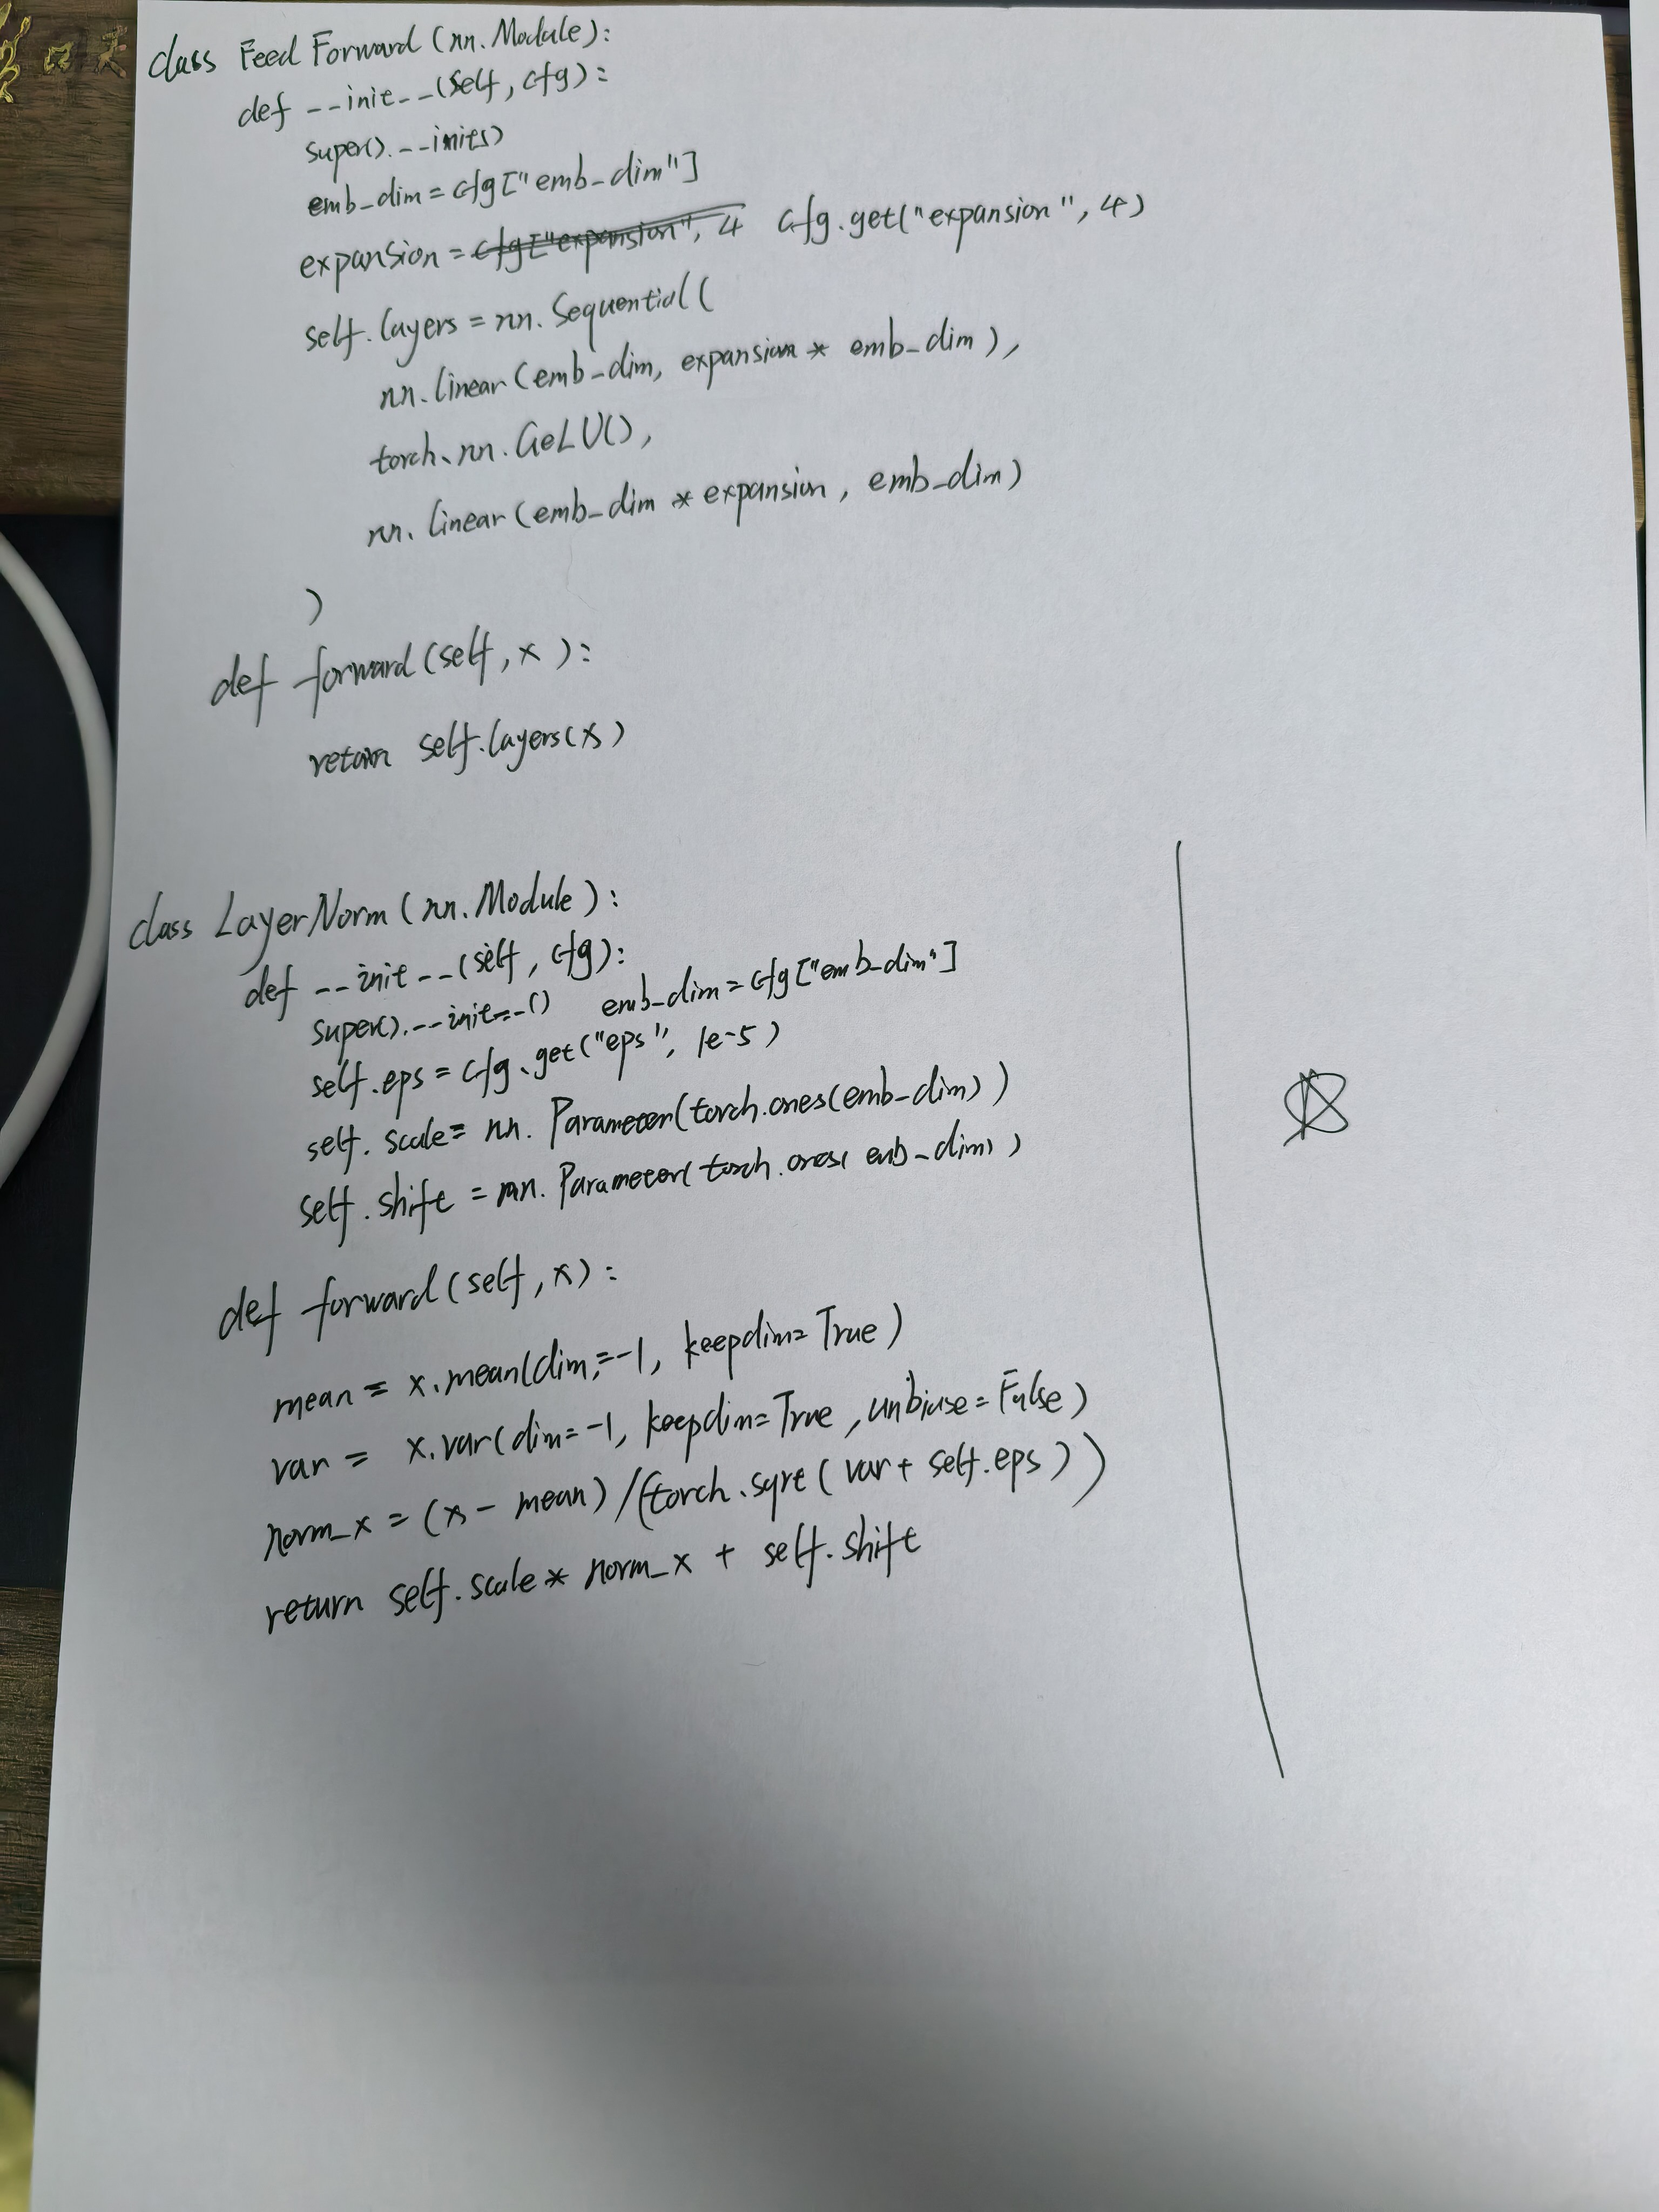
第二张:FeedForward 和 LayerNorm。 FFN 是我独立写的,升维 4 倍再降回来,中间 GELU。LayerNorm 是照抄的——均值、方差、标准化、scale/shift 这串统计细节,还没熟到能默出来。
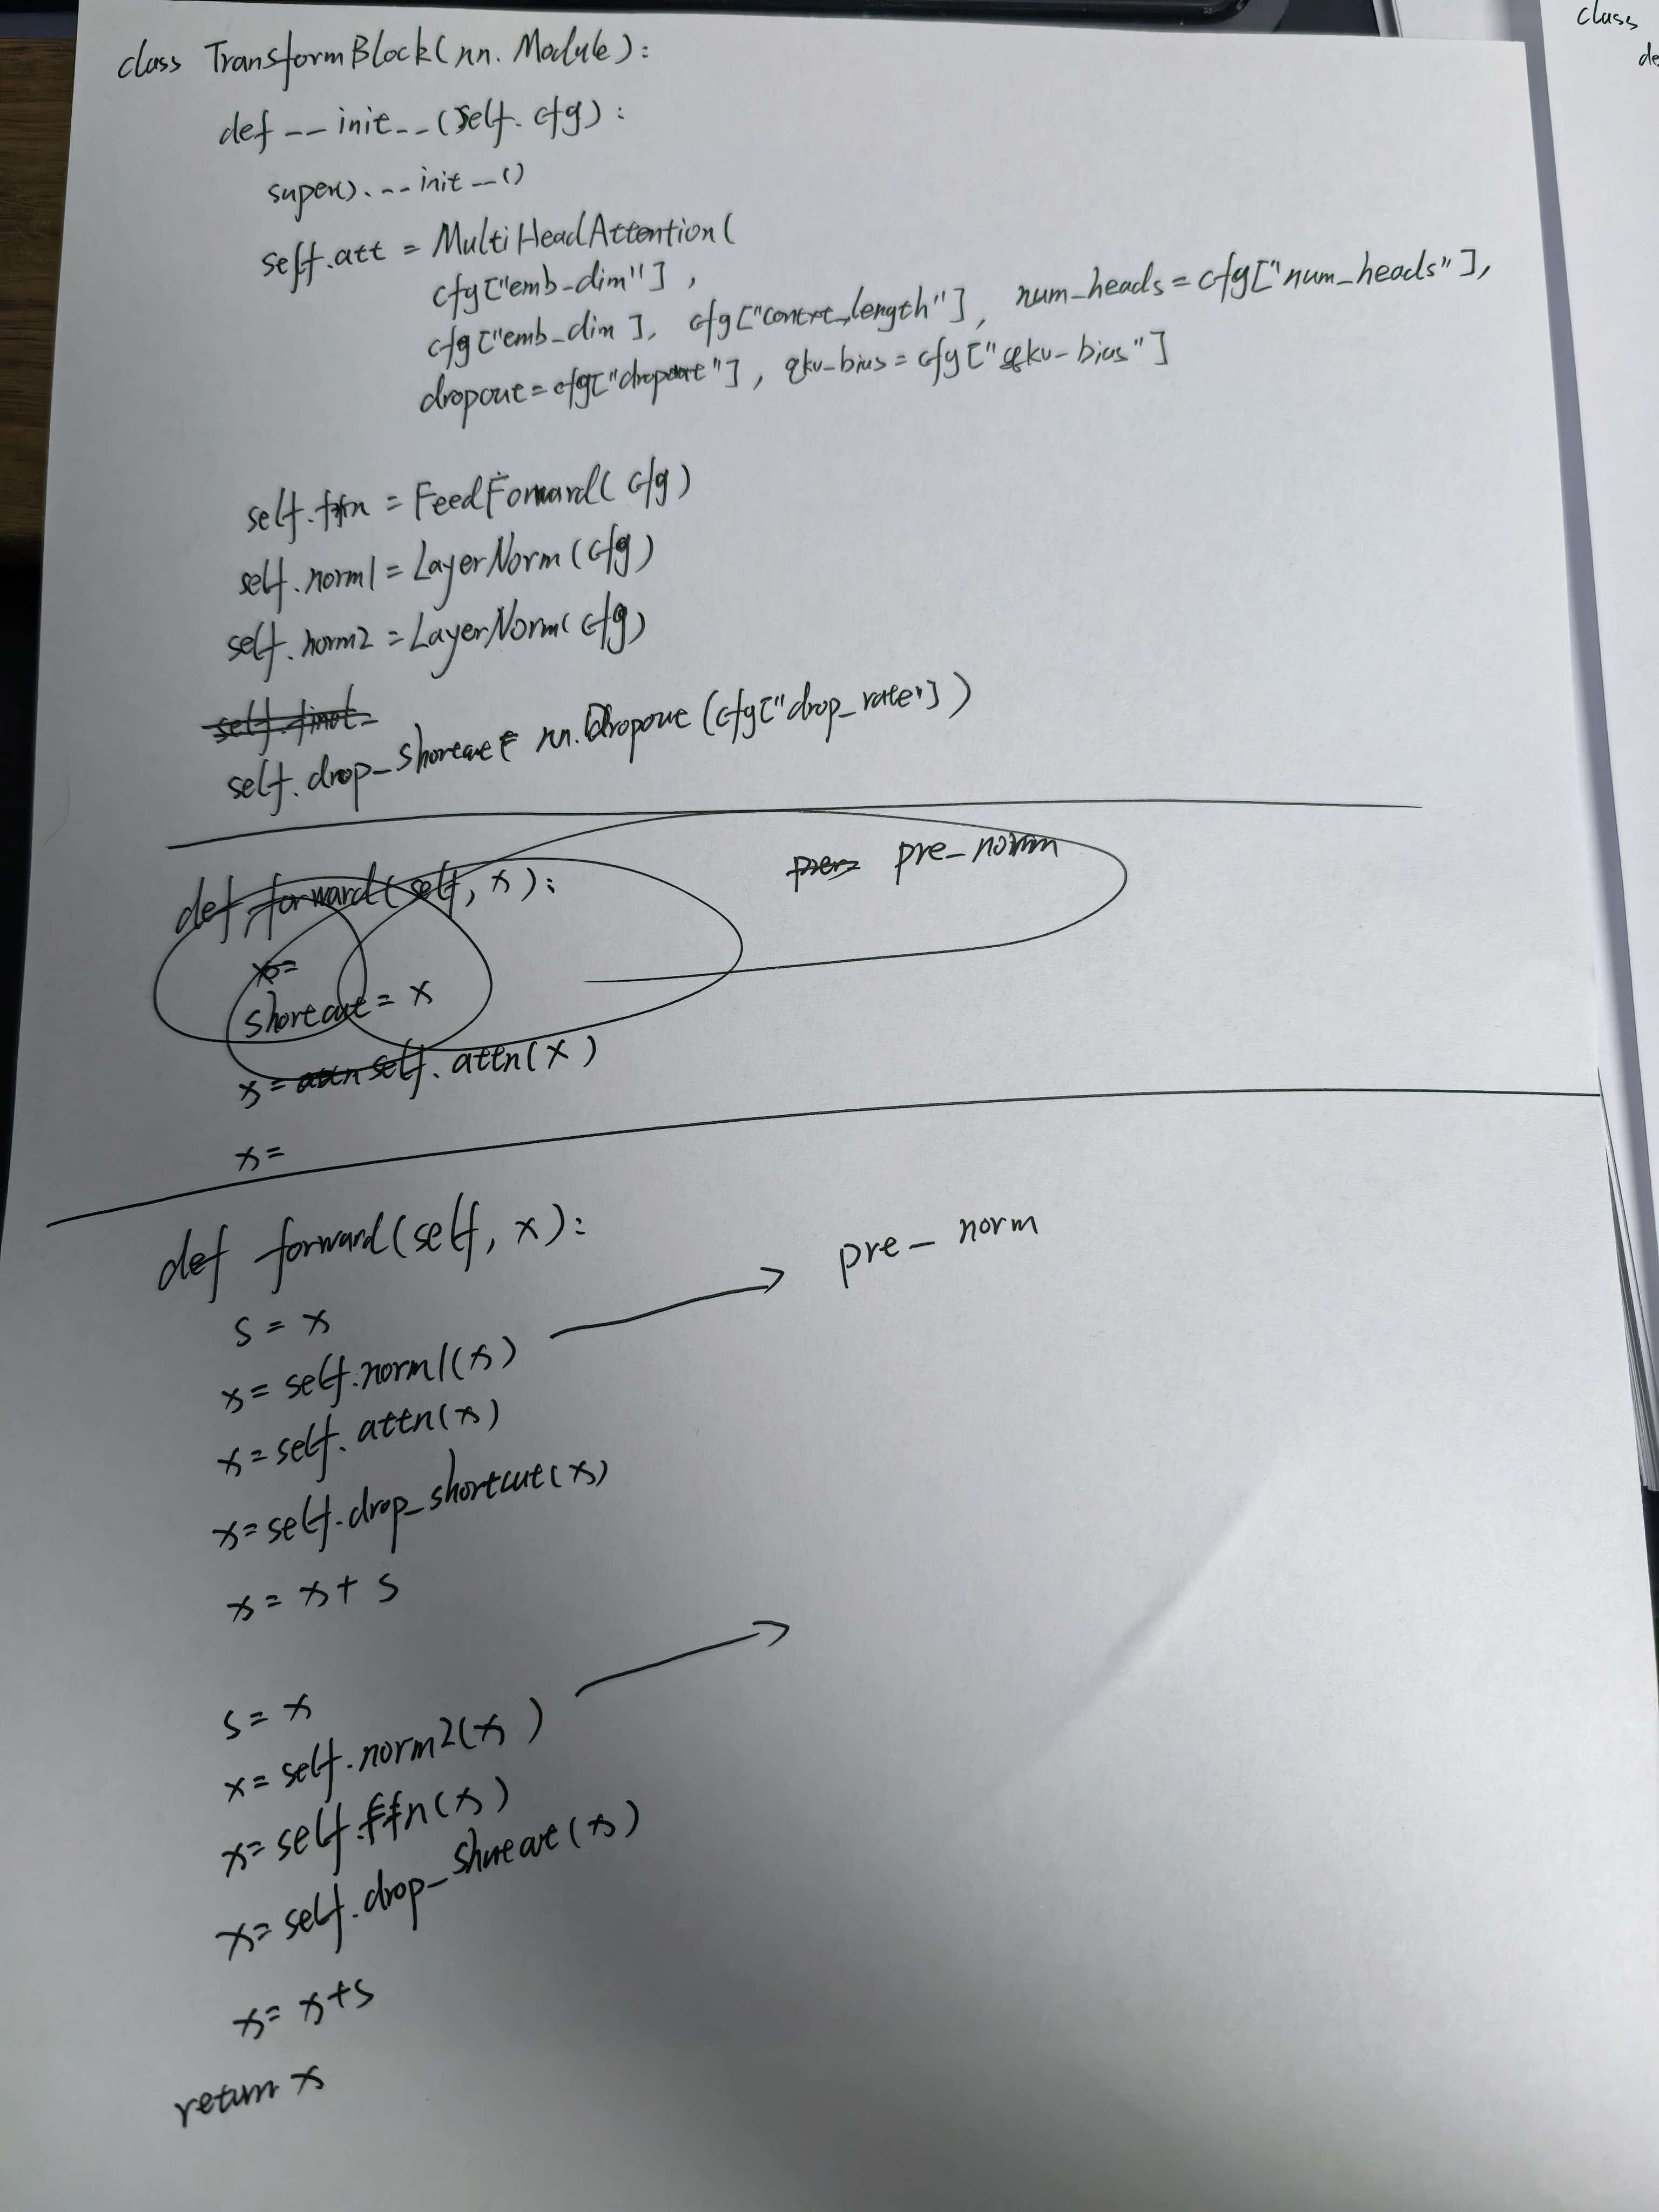
第三张:TransformerBlock。 att、ffn、norm1、norm2、drop_shortcut,还有 pre-norm 的残差结构。能默出 pre-norm 说明我不只是记住了“长什么样”,也记住了“为什么这么排”。
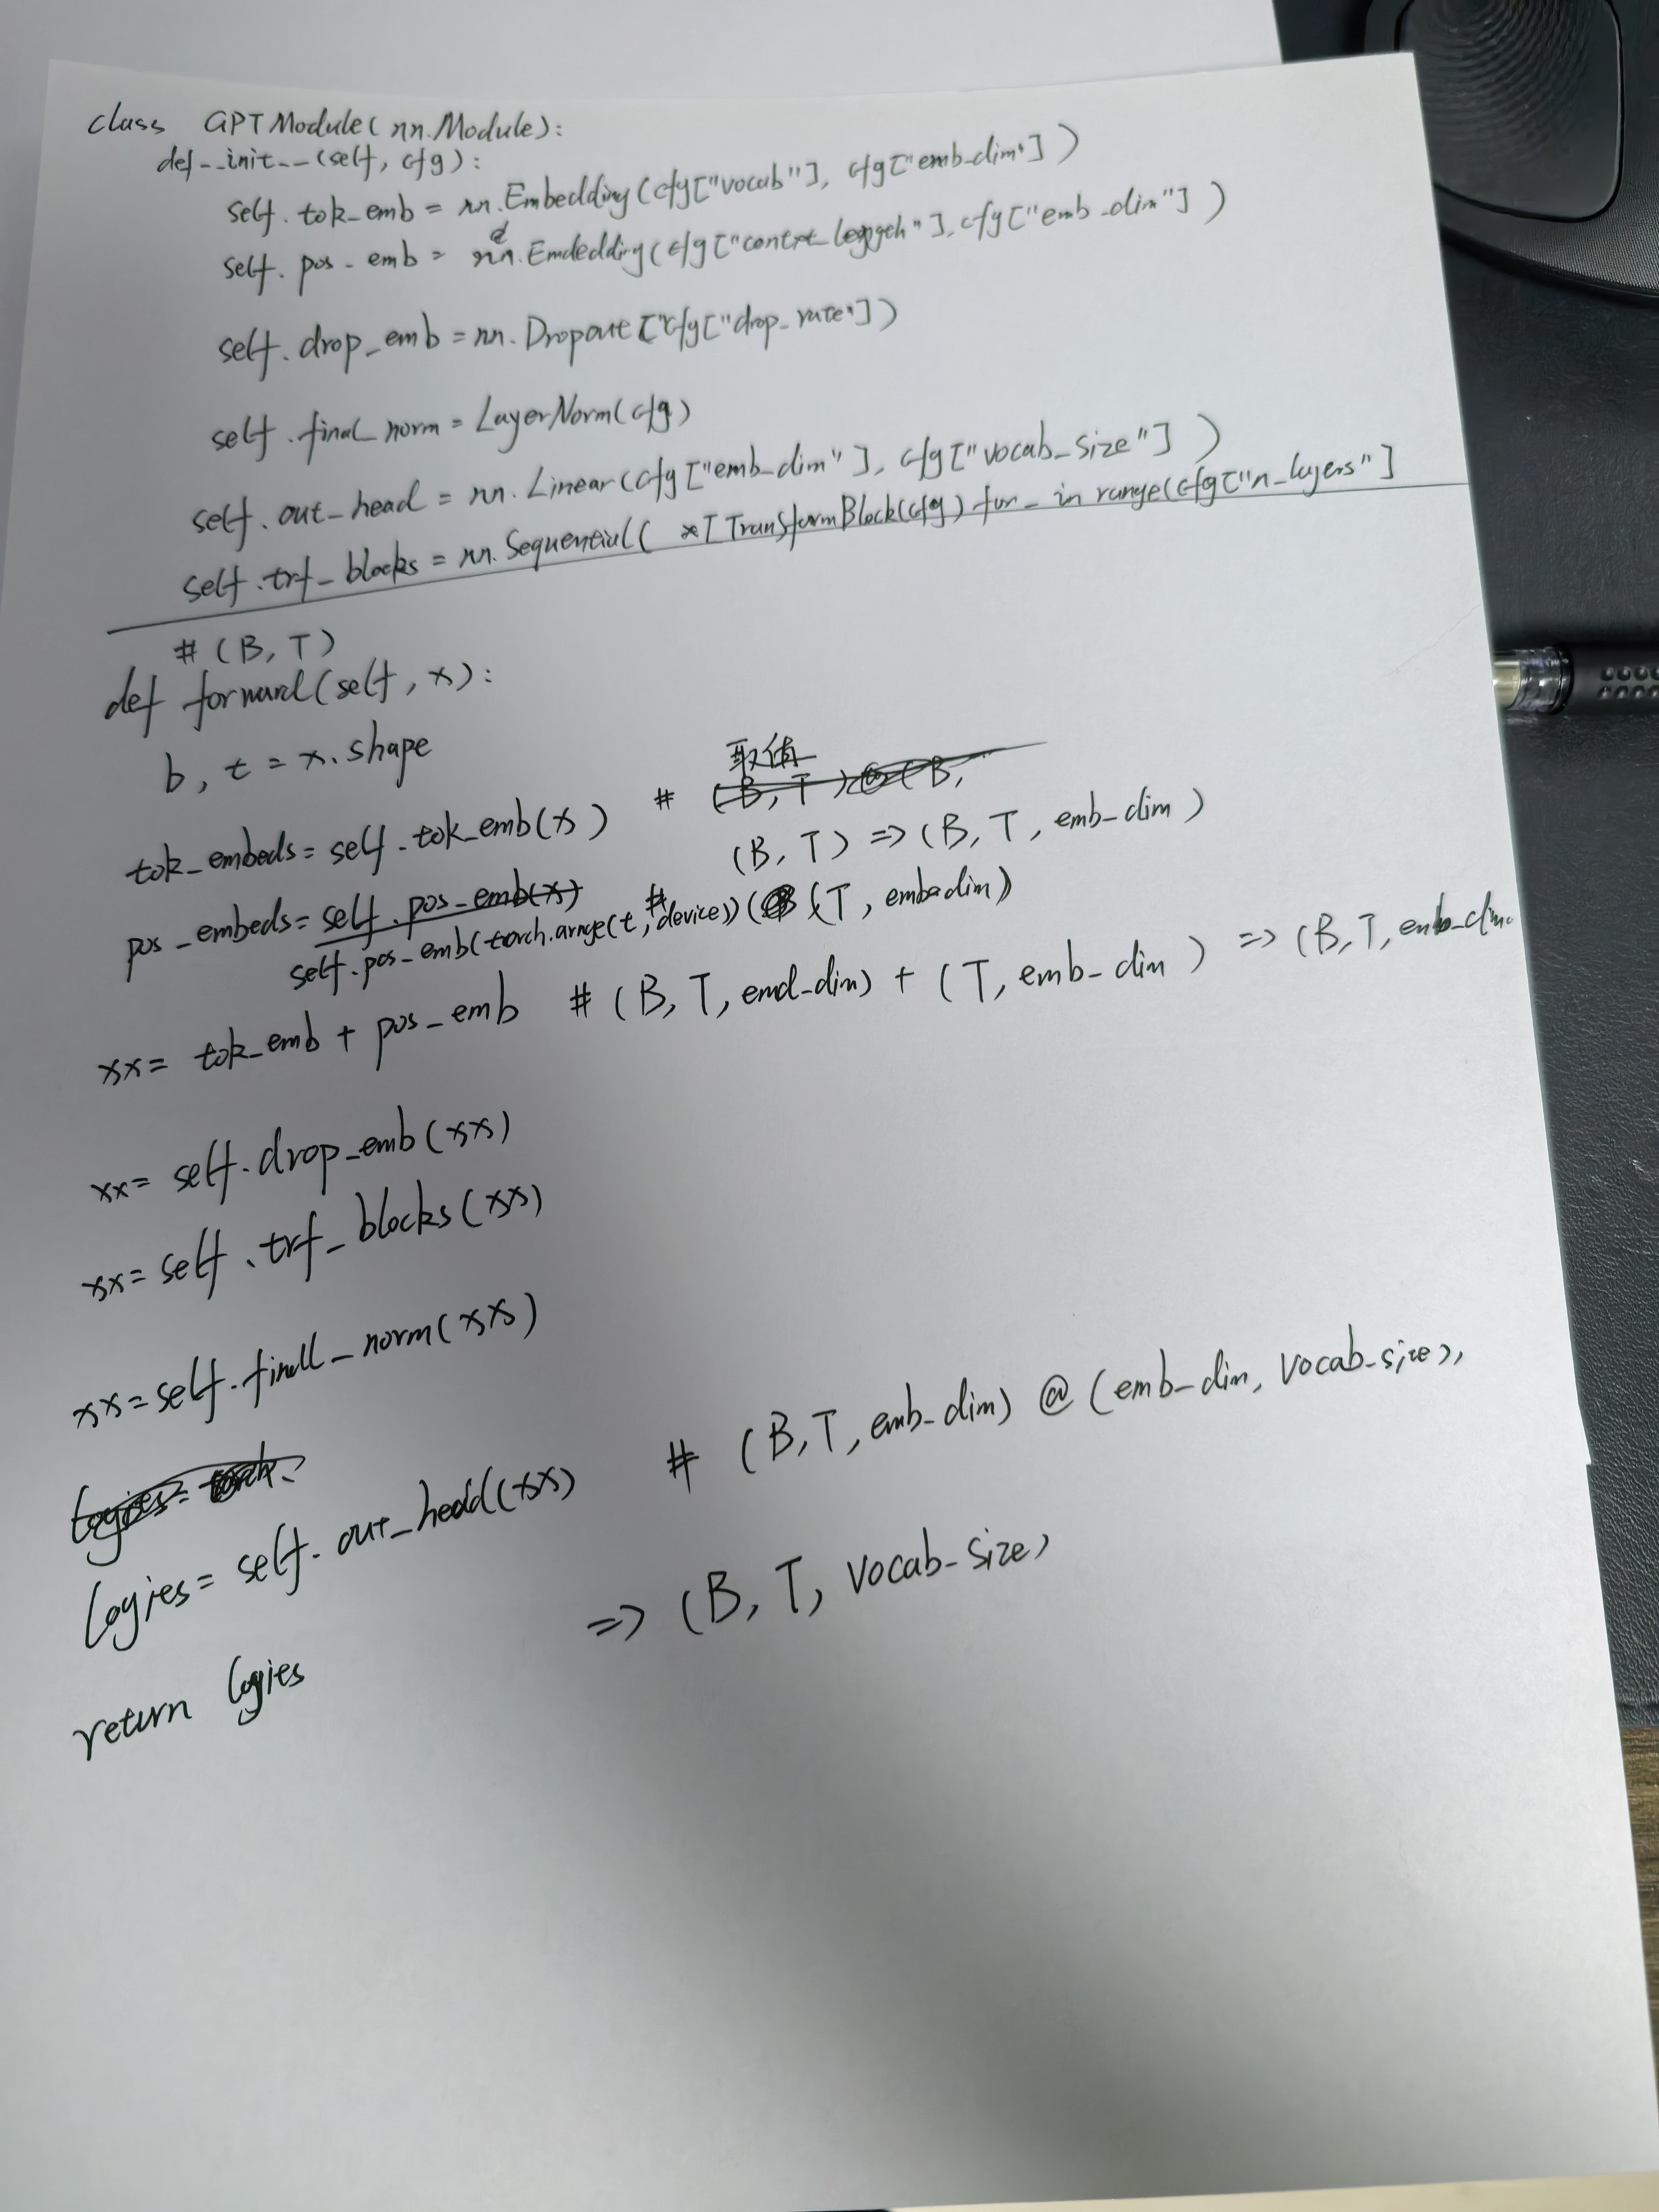
第四张:GPTModel。 tok_emb、pos_emb、drop_emb、trf_blocks、final_norm、out_head,以及 forward 的完整数据流和 shape 注解。
默写暴露了什么
说实话,结果比预期好,但细节缺失比想象多:
- MHA 的 mask 切片和 context_vec 的 transpose+view,是最先卡住的地方——但我是靠“shape 对不上”反推出来的,这比背下来强
- LayerNorm 基本是照抄的,统计细节(keepdim、unbiased、eps)没默全
- FFN、TransformerBlock、GPTModel 的主干都能独立写
结论很清楚:主干已通,统计细节和变形细节还没熟。 这不是“没学会”,是第二遍学习该有的样子——第一遍以为会了,第二遍默写才发现细节量。
接下来怎么办
两个动作:
- 只补漏,不全文重默。 mask、context_vec 变形、LayerNorm 的统计细节,单独写两遍
- 两周后再默一次。 拿这四张纸对照,看进步——间隔重复比连续默写有效得多
顺便把这次默写的一个小收获记下来:我还顺手推导了 nn.Embedding 和 nn.Linear 的区别——Embedding 是按 id 查表,Linear 是做矩阵乘法;两者都是可训练参数,但 Embedding 没有计算,只有索引。这个区别以前只是“知道”,默写的时候才真正想通。
默写这件事我会继续做下去。底座打得越熟,后面的 KV cache、MoE 才挂得住。
评论