训练大语言模型时,资源消耗可以直接转换成时间和成本的 所以需要资源核算
FLOPs(Floating Point Operations, 浮点运算次数) 衡量计算复杂度的一个指标,表示一个算法或者模型在执行过程中所需的浮点运算的总次数
经验公式:
总计算量 ≈ 6 ✖️ 参数量 ✖️ Token数量
6: fowrad 计算一次约为 2 ✖️ 参数量,backward 约等于前向的2倍,也就是 4 ✖️参数量
时间计算公式:
时间 = 总工作量 / 总算力
硬件算力可以查,H100 峰值算力约 1979TFLOPS (FP16/BP16数据类型,且启用结构化稀疏) 训练普通的稠密模型 理论峰值减半 约990 TFLOPs
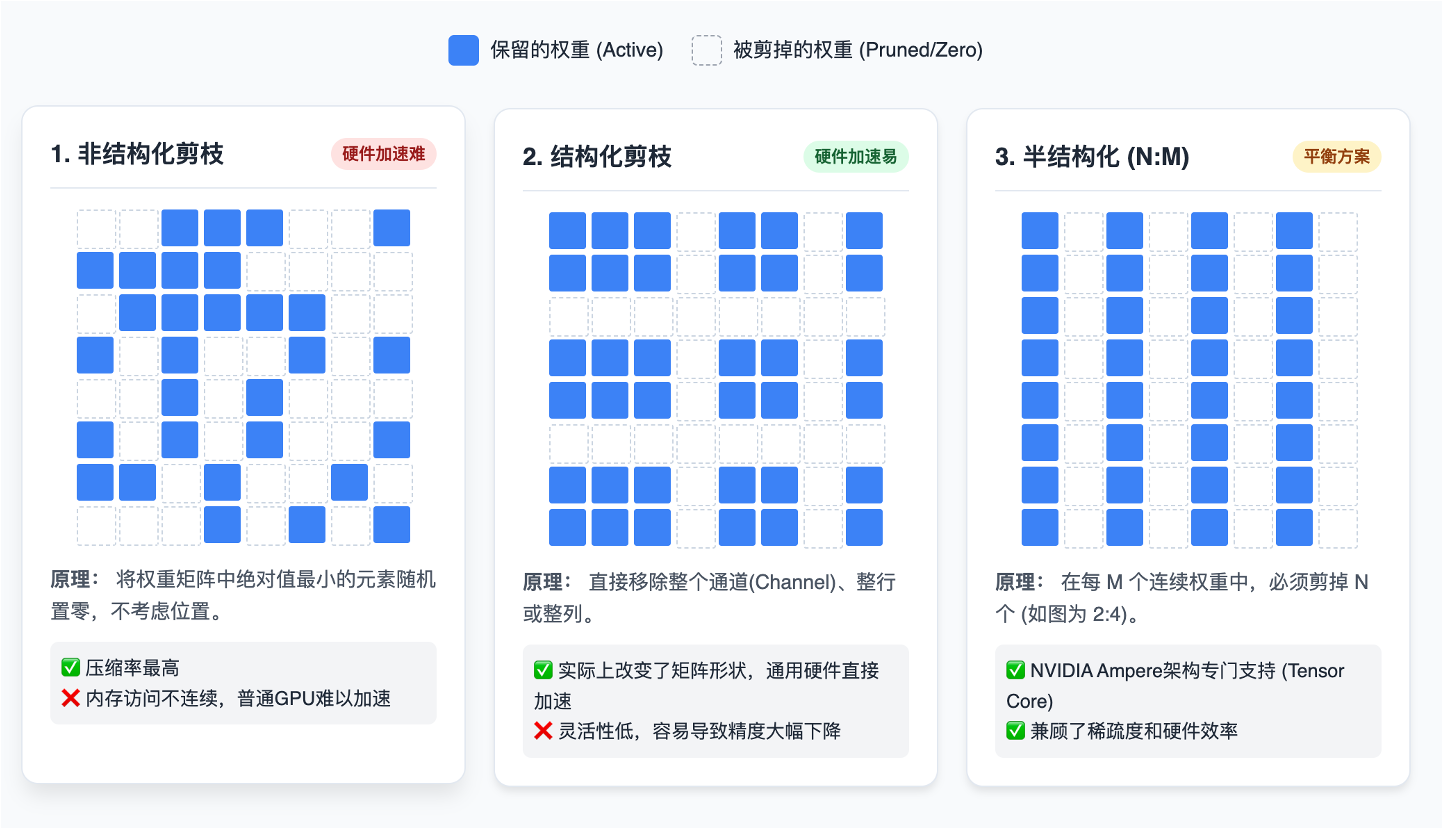
结构化稀疏: 一种模型压缩的方法,通常是对稠密模型按照50%的稀疏度进行剪纸
软硬件开销系数 (通常按照 30% ~ 60% 利用率估算更现实)
所以 在 1024 张 H100 显卡上,训练一个 70B(700亿参数)的模型,数据量是 15T(15万亿 tokens),大概要多久?
$$ \text{时间} = \frac{\text{总工作量}}{\text{总算力}} = \frac{6.3 \times 10^{24}}{5 \times 10^{17}} \approx 1.26 \times 10^7 \text{ 秒} \approx \mathbf{146} \text{ 天} $$FP16 和 BF16 都是计算机中用于表示小数的浮点数数据类型,它们在深度学习(AI 模型训练和推理)中被广泛使用。它们的主要目的是减少内存占用并加速计算(因为占用空间比传统的 FP32 少一半) FP16 (Half Precision / 半精度浮点数) 精度高 但表示范围小 BF16 (Bfloat16 / 脑浮点数) 精度低 但表示范围极大
Percy 在课上解释说:“bf16 牺牲了精度来换取范围。对于深度学习来说,范围比精度重要得多,因为数值稳定性的主要威胁是溢出/下溢,而不是尾数精度不够。”
内存估算 需要同时考虑 参数,梯度,优化器状态(不同优化器 参数量不同)
张量 pytorch.tensor
jaxtyping 提供的维度命名(如 “batch seq hidden”)在当前 PyTorch 生态中主要是“文档性质”的,不会在运行时自动强制检查维度是否真的匹配名称,但它能极大地提升代码的清晰度和可靠性。
# 传统方式(容易写错维度顺序)
x = torch.ones(2, 2, 1, 3)  # batch seq heads hidden

# Jaxtyping方式(在类型注解中命名维度)
from jaxtyping import Float
x: Float[torch.Tensor, "batch seq heads hidden"] = torch.ones(2, 2, 1, 3)
使用 Einops 库对张量操作进行优化: Einops增加了少量语法开销,但其清晰的维度命名显著降低了调试难度,特别是在复杂的模型架构中 这个后续学习 记个待办
- FLOPs(小写s):执行的浮点运算总数,这是一个衡量计算量的指标,
- FLOP/s(每秒浮点运算):指硬件每秒能执行的浮点运算次数,也写作 FLOPS(大写S)。这是一个衡量“速度”的指标。例如,H100 GPU峰值性能为 990 TFLOP/s。
对比矩阵乘法 A (m×k) @ B (k×n) 的 FLOPs = 2 × m × k × n。当 k 较大时(如 k = 1024),矩阵乘法的 FLOPs 是加法的上千倍。对于现代深度学习模型(尤其是 Transformer、MLP 等),90%+ 的 FLOPs 来自矩阵乘法(线性层、QKV 投影、FFN 等)。其他操作(LayerNorm、Softmax、激活函数、加法残差连接等)虽然存在,但 FLOPs 可忽略不计。因此,在进行粗略但有效的资源估算时,只需计算所有矩阵乘法的 FLOPs 总和即可。
调用 loss.backward() 后,PyTorch 会从 loss 开始,沿着计算图回溯,自动计算出每个需要梯度的张量的梯度。
一个普适性的结论:在深度学习中,训练一次(前向+反向)的总 FLOPs 约等于 6 倍的“数据点数量 × 参数数量”
在每次迭代开始前,需要清空上一次计算得到的梯度,否则梯度会累积。优化器在调用 zero_grad 函数清空梯度时,设置 set_to_none=True 是一种更高效的内存管理方式,它会将梯度指针设为 None,而不是将其置零,可以节省内存。
optimizer.zero_grad(set_to_none=True)
检查点(Checkpointing)
大型语言模型的训练耗时极长,过程中几乎不可避免地会发生崩溃或中断,我们需要一种机制来保存进度,以便在中断后能够从中断点恢复,而不是从头开始
检查点需要包含两块,模型参数 和 优化器状态
为了能够完整地恢复训练,检查点必须包含所有必要的状态信息。主要包括两个核心部分:
- 模型参数:这是模型的核心,包含了所有可学习权重(nn.Parameter)的当前值。通过 model.state_dict() 可以获取一个字典,其中键是参数名称,值是对应的张量数据。 -优化器状态 (optimizer.state_dict()):这是很多人容易忽略但极其关键的部分。优化器(如 Adam、AdaGrad)不仅存储了当前的学习率,还维护着一些内部状态变量。 例如: 如果只保存了模型参数而没有保存优化器状态,那么在恢复训练时,优化器会从零开始,这会导致训练过程不连续,性能下降,甚至可能无法收敛。
checkpoint 保存检查点
# 1. 创建一个字典,包含模型和优化器的状态
checkpoint = {
    "model": model.state_dict(),
    "optimizer": optimizer.state_dict(),
}

# 2. 使用 torch.save 将字典序列化并保存到磁盘文件
torch.save(checkpoint, "model_checkpoint.pt") # 文件名通常使用 .pt 或 .pth 后缀
加载也需要两部分同时加载:
# 1. 从磁盘文件加载保存的字典
loaded_checkpoint = torch.load("model_checkpoint.pt")

# 2. (后续步骤)将状态加载回模型和优化器
model.load_state_dict(loaded_checkpoint["model"])
optimizer.load_state_dict(loaded_checkpoint["optimizer"])
混合精度训练 (Mixed Precision)
将低精度(BF16/ FP 16) 用于消耗大但对精度要求不高的部分(激活值)。将高精度用于 对精度敏感的部分(参数和梯度)
PyTorch 的 AMP 库 (Automatic Mixed Precision):PyTorch 提供了自动混合精度(AMP)库,会自动将安全的操作(如矩阵乘法)转为 bf16,将危险操作(如 exp、softmax)保留为 fp32:
with torch.amp.autocast("cuda", dtype=torch.bfloat16):
    x = torch.zeros(4, 8)  # 自动以 bf16 创建
数据搬运也是需要时间,所以总时间取决于 加速器速度FLOP/s 和 内存带宽Bytes/s
算术强度
为了避免每次都要计算两个时间再比较,引入算术强度(Arithmetic Intensity):
加速器强度 = FLOP/s / Bytes/s H100 约295FLOP/bytes 算数强度 = FLOPs / Bytes 该操作每搬运1字节能做多少FLOP
算数强度 < 加速器强度 Memory-bound 瓶颈在数据传输 算数强度 > 加速器强度 Compute-bound 瓶颈在计算
python中 列表的append()和extend 都是原地修改列表。
append(x):把 x 当作一个整体元素加到末尾
a = [1, 2]
a.append([3, 4])
print(a)  # [1, 2, [3, 4]]
extend(iterable):把可迭代对象里的元素逐个拆开加到末尾
a = [1, 2]
a.extend([3, 4])
print(a)  # [1, 2, 3, 4]
extend 接收的是可迭代对象,比如列表、元组、字符串、集合等
今天的坑(M2 开工实录)
梯度累积:三次 backward 一次 step
一开始写成了“把所有 loss 攒进 list,最后一次 backward”——这样所有计算图都攒在手里,显存越攒越大,完全背离了梯度累积的初衷。正确姿势是每个小批立刻 backward(释放计算图),梯度累加在 .grad 里,攒够 N 批再 optimizer.step()。
归一化也有两种等价写法:sum(loss_i)/N 和每个 loss_i/N 再 backward,因为梯度是线性的,结果一样,但后者省显存。
触发条件用 (i+1) % accum_step == 0 一个表达式通吃,不用给 accum_step=1 单写分支。
zero_grad 的位置决定成败
原来的老代码在循环顶部 zero_grad(),改成累积模式后如果还留着,前几批攒下的梯度还没 step 就被清掉了,累积直接白干。口诀:梯度只在“用掉之后”清零(step 之后),不能在“攒的过程中”清零。
.gitignore 的目录匹配会误伤
写 data/ 会匹配所有层级的 data 目录,把 src/squid/data/ 代码包也忽略了(新文件变灰、git status 看不到)。要只排除根目录的语料目录,必须写 /data/(前导斜杠锚定根目录)。
total_loss 是 list 不是张量
total_loss / accum_step 会炸,因为 list 不能除以整数;而且把 loss 存进 list 不 backward,等于把计算图全留着。loss 是张量,应该当批归一化后立刻 backward,不是攒起来。
BPB 的含义与“下降意味着什么”
BPB(Bits Per Byte)的本质是衡量语言模型把文本压缩了多少:给这段文本编码,平均每个字节要花多少比特。数值越低,说明模型对文本的预测能力越强,压缩效率越高。
两个参照点帮助记忆:
- BPB 接近 0:模型几乎能完美预测文本,每个字节只需极少比特
- BPB = 8:完全不会预测,每个字节都得老老实实存 8 bit,等于没有压缩
所以 BPB 下降 = 模型用更少的比特就能编码同样的文本 = 模型在变好。它和 val_loss 下降的区别是:val_loss 是“每个 token 的预测难度”,BPB 把它折算成了“每个字节的成本”——这样不同词表、不同模型之间才能公平比较。
容量与深度扫描:数据决定上限
M2 最小闭环之后,用同一批语料、同一训练量做了容量与深度对照,结论比配置本身值钱。
emb_dim 扫描(20 epoch,其他锁死)
| emb_dim | 最终 val_loss | BPB | 结论 |
|---|---|---|---|
| 64 | 7.02 | 3.63 | 容量不足 |
| 128 | 6.59 | 3.42 | 仍在受益 |
| 256 | 5.99 | 3.10 | 甜点 |
| 512 | 6.26(过拟合) | 3.24 | 开始背语料 |
512 出现了教科书式的过拟合:train_loss 一路降到 1.8,val_loss 却从 5.85 回升到 6.29——模型在背训练集,不是在学规律。所以容量甜点在 256 附近:64 欠拟合、512 过拟合。
验证代码:
"""M2 收官:真实语料 + 自训 BPE 的完整预训练。

链路:pack_tokens 打包 → create_stream_loader → 小 GPT 预训练
      → bpb 曲线 → generate_text 咿呀学语 → save_checkpoint 带 config。
"""
import math
from pathlib import Path

import torch

from squid.data.token_stream import pack_tokens, create_stream_loader
from squid.device import get_device
from squid.generate.text import generate_text
from squid.model.gpt import GPTModel
from squid.train.common import calc_loss_loader
from squid.train.pretrain import pretrain_model
from squid.tokenizer.my_bpe_tokenizer import MyBPETokenizer
from squid.checkpoints.store import save_checkpoint

ROOT = Path(__file__).resolve().parents[1]
DATA = ROOT / "data" / "blog"


def test_m2_pretrain():
    device = get_device()
    tokenizer = MyBPETokenizer.from_directory(DATA / "m2000")

    # 1. token 流打包:训练语料与 held-out 分别打包
    train_text = (DATA / "train.txt").read_text(encoding="utf-8")
    val_text = "\n".join(p.read_text(encoding="utf-8") for p in DATA.glob("heldout-*.txt"))

    train_ids = pack_tokens([train_text], tokenizer, tokenizer.eos_id)
    val_ids = pack_tokens([val_text], tokenizer, tokenizer.eos_id)

    context = 128
    train_loader = create_stream_loader(train_ids, context, batch_size=8, shuffle=True)
    val_loader = create_stream_loader(val_ids, context, batch_size=8,
                                      shuffle=False, drop_last=False)

    # 2. 小模型:emb_dim 64、2 层、context 128
    cfg = {
        "vocab_size": len(tokenizer.vocab),
        "context_length": context,
        "emb_dim": 256,
        "n_heads": 2,
        "n_layers": 4,
        "drop_rate": 0.0,
        "qkv_bias": False,
    }
    model = GPTModel(cfg).to(device)
    optimizer = torch.optim.AdamW(model.parameters(), lr=3e-4)

    # 3. 预训练:accum_step=4,bpb 用 held-out 的 bytes/token 折算
    density = len(val_text.encode("utf-8")) / len(tokenizer.encode(val_text))
    train_losses, val_losses, tokens_seen = pretrain_model(
        model, train_loader, val_loader, optimizer, device,
        num_epochs=20, eval_freq=50, eval_iter=5,
        accum_step=4, bpb_density=density,
    )
    assert val_losses[-1] < val_losses[0], "val loss 应该下降"

    # 4. 咿呀学语:给模型一个开头,看它续什么
    sample = generate_text(model, tokenizer, "大模型",
                           max_new_tokens=40, context_size=context,
                           temperature=0.8, top_k=20, eos_id=tokenizer.eos_id)
    print("\n=== 生成样例 ===\n", sample)

    # 5. 存档:权重 + config + 元信息,完整还原训练现场
    final_val = calc_loss_loader(val_loader, model, device)
    save_checkpoint(ROOT / "regression" / "m2-pretrain.pth",
                    model, cfg, val_loss=final_val, merges=2000, tokens_seen=tokens_seen[-1])
    print(f"\n最终 val_loss={final_val:.3f},checkpoint 已保存")
n_layers 对照(emb_dim=256)
4 层和 2 层基本持平(val_loss 6.03 vs 5.99),深度没有收益,后段 val 还开始上翘。最优配置停在 emb_dim=256、n_layers=2。
一句话总结:小数据面前,模型不是越大越好,是“配得上”才好。 压缩率有甜点、BPB 有甜点、模型容量也有甜点——全是测出来的,不是猜的。
两个收尾的 bug
accum_step 大于每轮批次数:每 epoch 只有 4 个 batch,accum_step=5 时 (i+1) % 5 == 0 永远不成立,optimizer.step() 一次都不执行,模型完全不学。改成跨 epoch 的 global_step 连续计数才解决。以后看到 loss 完全不动,先查 step 到底执行了没有。
decode 的 UnicodeDecodeError:字节级 BPE 的 token 可能只是半个汉字,模型自由生成的序列不一定是合法 UTF-8,直接 decode 会炸。改成 decode("utf-8", errors="replace"),非法片段显示为替换符即可——tiktoken 默认就是这么干的。
评论