M6 的目标不是让模型突然变聪明,而是让自己写的模型第一次像一个真正可调用的程序。
从测试脚本走向对话产品
在 M5 里,模型已经能完成选择题、自由生成和结构化评估。但每次运行都依赖测试脚本,还不能算一个真正能使用的产品。
M6 要做的是对话界面:
命令行多轮对话 CLI
+
轻量 Web 对话页
+
浏览器输入 → 推理服务 → 自训 355M 模型 → 页面展示回答
这一步不再改模型结构,而是把已有能力组织成一个最小应用。
第一层:ChatSession
多轮对话首先需要一个状态容器。ChatSession 保存模型、tokenizer、生成参数和对话历史。
history 里只保存原始问答:
[
    ("用户第一轮问题", "模型第一轮回答"),
    ("用户第二轮问题", "模型第二轮回答"),
]
### Instruction: 和 ### Response: 不直接存进 history,而是在每次调用模型前,由 build_chat_prompt 重新组装。
这样原始对话和训练模板分开保存,不会每轮重复叠加格式标记。
回答截取与写入 history
generate_text 返回的是完整 prompt 加生成内容,所以本轮回答需要重新截取:
response = responses[len(prompt):].replace(
    "<|endoftext|>", ""
).strip()
self.history.append((user_input, response))
return response
这里有两个容易踩的坑:
- 返回
responses会把完整 prompt 一起交给调用方; - 不清理
<|endoftext|>,结束标记就会以普通文本形式出现在回答里。
遗忘窗口:不是保留前 1000 轮
history 不能无限增长。第一版使用最近 5 轮的滑动窗口:
self.history.append((user_input, response))
self.history = self.history[-self.max_history_turns:]
需要区分两个限制:
- 轮数限制:防止 history 无限增长;
- token 限制:防止模型上下文超出
context_length。
即使只有 5 轮,如果每轮都特别长,也可能超出模型窗口。M6 先使用轮数控制,后续更严谨的做法是按 token 预算逐轮遗忘。
第二层:CLI 多轮对话
scripts/chat_cli.py 负责真正的终端交互。
启动时只加载一次 SFT 权重、tokenizer 和 ChatSession,然后进入循环:
读取输入
→ /exit 退出
→ /clear 清空历史
→ 普通问题调用 session.ask
→ 打印本轮回答
→ 继续下一轮
模型加载不能放在循环里,否则每轮都重新加载一次权重,既慢又浪费内存。
第一次报错:生成参数没有传
第一次调用时直接得到:
TypeError: generate() missing 2 required positional arguments:
'max_new_tokens' and 'context_size'
原因是 generate_text 只通过 **kwargs 转发参数,而 ChatSession.ask 最初没有传。
最后在 Session 中保存生成配置,并在调用时传入:
responses = generate_text(
    self.model,
    self.tokenizer,
    prompt,
    max_new_tokens=self.max_new_tokens,
    context_size=self.context_size,
    eos_id=self.tokenizer.eos_id,
)
eos_id 也必须传递,否则模型即使生成了结束标记,生成循环也不知道应该停止。
打印格式问题:不是 CLI 的错
最开始模型回答里又出现了新的 ### Instruction: 和 ### Response:。
通过打印原始返回值,确认 PREFIX_MATCH=True,说明 prompt 截取没有问题。那些格式标记是模型自己生成的,不是 history 被误打印。
继续检查后,还发现当前 prompt 少了 SFT 训练时的固定说明头:
Below is an instruction that describes a task. Write a response that appropriately completes the request.
补回以后,模型不再随意编造下一轮格式。
这个案例再次说明:不能只看页面表面像不像 bug,要沿着 prompt、原始输出和截取结果逐层定位。
第三层:最小 HTTP 推理服务
M6 没有引入 FastAPI 或 Flask,而是先用 Python 标准库的 http.server,把 HTTP 请求和响应本身看清楚。
第一步先做健康检查:
GET /health → {"ok":true}
第二步再接对话:
POST /chat
→ 读取请求 body
→ json.loads
→ 取出 message
→ SESSION.ask(message)
→ 返回 {"response": ...}
模型在服务器启动时加载一次,后续请求共享当前 Session。
第一版是单会话演示,不做多用户、多会话隔离,也不做流式输出。这些属于后续推理服务优化,不在当前最小闭环里硬塞。
真实请求验证:
curl -X POST http://127.0.0.1:8000/chat \
  -H 'Content-Type: application/json' \
  -d '{"message":"What is the capital of France?"}'
返回:
{"response": "The capital of France is Paris."}
到这里,CLI 和 HTTP 推理服务都已经跑通。
第四层:纯 HTML Web UI
最后新增 web/chat.html,不使用前端框架,直接用 HTML、CSS 和 JavaScript。
页面包含:
- 用户和模型的消息气泡;
- 输入框与发送按钮;
- 生成中的加载状态;
- 请求失败提示;
- Enter 发送、Shift+Enter 换行;
- 移动端布局。
浏览器通过 fetch("/chat") 调用刚才的接口。
用户输入和模型输出都通过 textContent 插入页面,不使用 innerHTML,避免把模型返回的文本误当成 HTML 执行。
服务器访问 / 时返回这个页面:
/         → Web 对话页
/health   → 健康检查
/chat     → POST 对话接口
所以正确访问方式是:
http://127.0.0.1:8000/
不是双击 chat.html 使用 file://,也不是访问 /web/chat.html。
浏览器验收截图
下面这张图记录了从浏览器输入问题,到本地 355M 模型返回回答的真实过程:
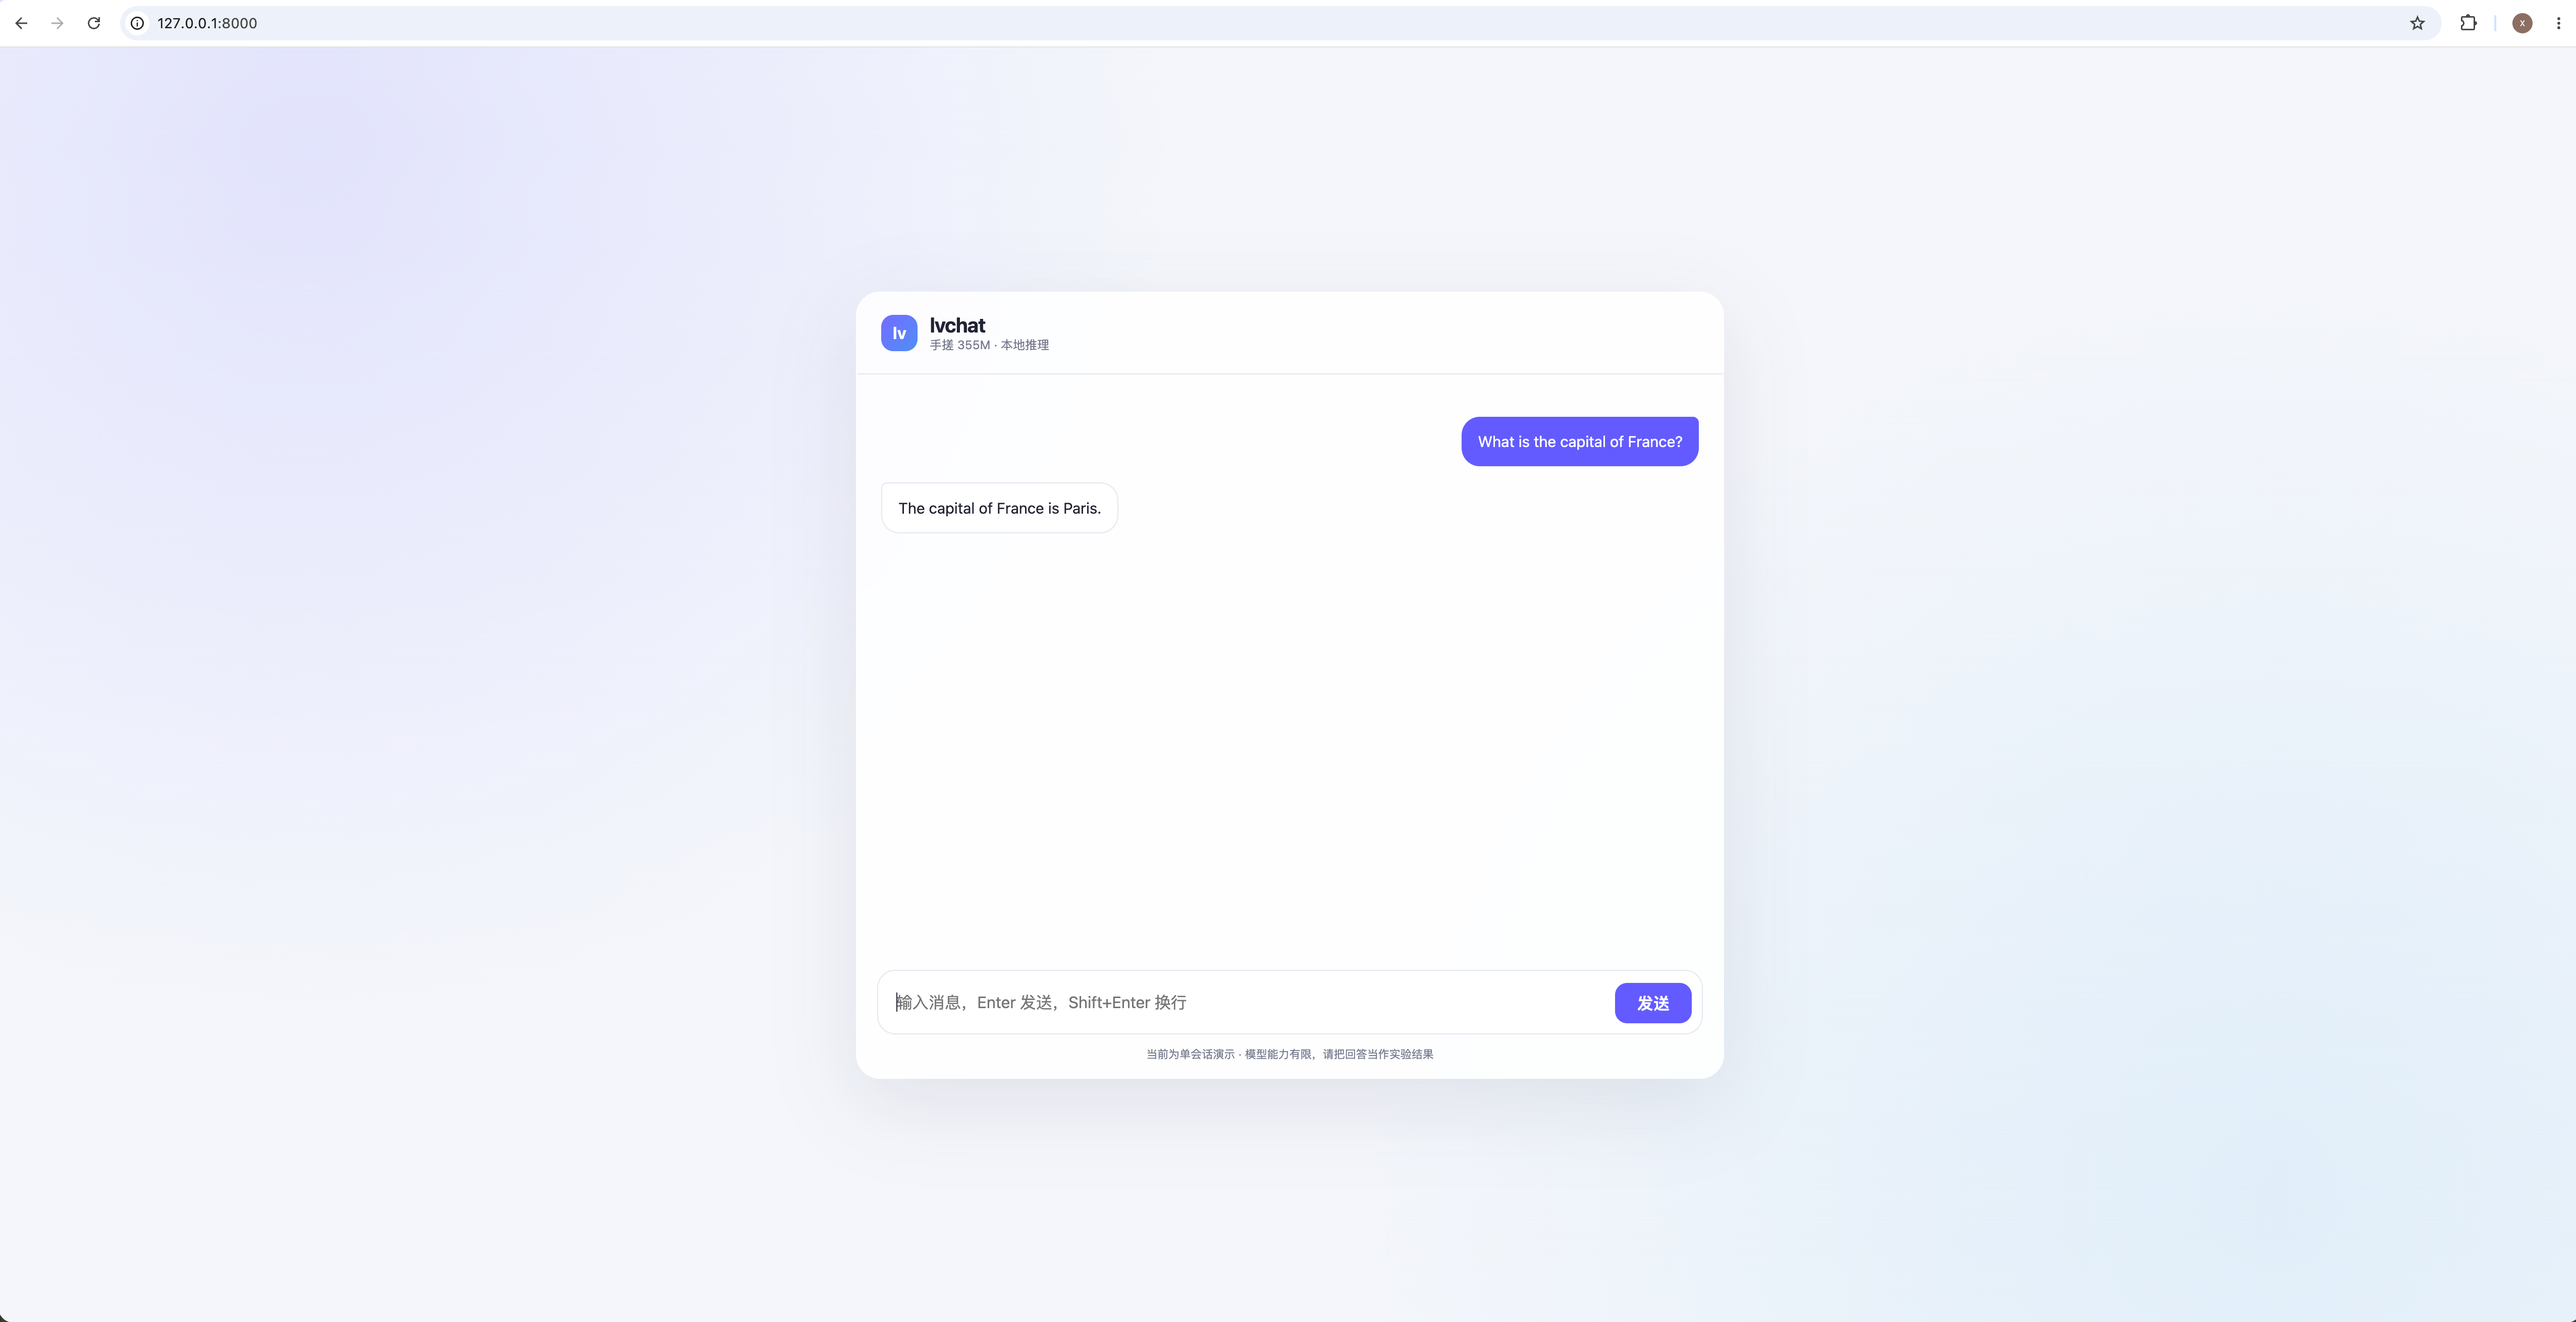
看到这个页面时,第一季的主线终于不再只是模型代码和训练脚本,而是变成了祁总可以直接打开、输入和使用的程序。
但多轮对话能力没有通过
页面上线后,我继续测试,很快发现了一个不能掩盖的问题:
第一轮问法国首都,模型回答 Paris。接下来输入 What、你好啊,模型仍然反复回答 Paris。
我按相同输入顺序,用全新的 ChatSession 成功复现了这个问题。
单独通过 HTTP 发送不同请求,又能得到不同回答,因此不是前端固定文案,也不是服务器写死返回 Paris。
真正的问题在模型:当前 355M SFT 模型没有经过可靠的多轮对话训练,历史里一旦出现上一轮回答,它就容易把旧答案复制到下一轮。
我还尝试过把 history 从重复的 Instruction/Response 块移到 ### Input:,结果模型开始复读 Previous conversation:,所以没有保留这次无效修改。
因此 M6 的结论必须分两层:
CLI、HTTP、Web 页面和模型调用的工程链路已经跑通;但当前模型不具备可靠的多轮对话能力。
页面能用,不等于模型多轮语义能力合格。这个问题后续需要通过更强底座或专门的多轮对话 SFT 解决,而不是在前端把重复回答隐藏起来。
M6 最终验收
完成的内容:
ChatSession与原始问答 history;- 最近 5 轮的滑动窗口;
- CLI 多轮输入、
/clear和/exit; - 标准库 HTTP 推理服务;
- 纯 HTML/CSS/JavaScript Web UI;
- 真实浏览器端到端调用;
- 对多轮复制问题的复现、分析和无效方案回滚。
未完成或明确留到后面的内容:
- 可靠的多轮语义对话;
- 多会话隔离;
- 流式 SSE 输出;
- 会话级 KV cache;
- 按 token 预算进行 history 遗忘。
M6 不是终点,也不是一个完美产品。但它让从零手搓的模型真正穿过了命令行、HTTP 和浏览器。
工程闭环成功了,模型边界也被测出来了。失败也是成功的一种,因为这次失败同样可复现、可解释、可继续改进。
评论