上一篇的结尾贴了 355M 的答卷:33.5 分,58 条 0 分。分数难看,但证据链是完整的——也正因为完整,才看得清问题不在训练脚本,而在底座。这篇是它的对照组:同一份数据、同一个判官、同一个 110 条测试集,把模型从手搓的 GPT-2 355M 换成 Qwen2.5-1.5B base,再做一次指令微调。系列规则不变:写下来的必须是我自己搞懂的,翻车的地方如实写。
一、起点:33.5 分和 58 个 0 分,问题出在哪
上一篇的记录里,GPT-2 355M 用 1100 条 Alpaca 数据全参微调 2 个 epoch,DeepSeek 判官给出的结果是:
mean = 33.5    median = 0    0 分 = 58 条(52.7%)
exact match(归一化)= 15.5%
平均回答长度 = 17 token,128 token 截断 1 条,模板残留 2 条
(上一篇贴的是 33.9 / 57 条,本文统一用留存文件重算的 33.5 / 58 条。同一份回复两次打分差 0.4 分——这本身就是本篇后半段要展开的主题:评委是变量。)
当时做过一轮归因:58 个 0 分里,没有一条是空回答、模板残留或截断,全是“正常文本但答错了”。典型的样本:
| 指令 | 正确答案 | 355M 的回答 |
|---|---|---|
| chlorine 的元素符号 | Cl | C |
| 找出句式类型 | interrogative | imperative |
| 改写句子(被动→副词) | The lecture was delivered clearly. | 原句照抄 |
| 生成幽默轶事 | Why was the math book sad?… | 编了个无关的长故事,被 128 token 截断 |
配合 train loss 0.30 / val loss 0.64 的过拟合曲线,结论很朴素:格式它学会了,知识它没有。1100 条数据改变不了底座的厚度。
于是有了那个命题——预训练决定“知道什么、能做什么”,后训练决定“怎么表现出来”。这个命题要在这一篇里被定量验证。
二、换底座:为什么最后是 Qwen2.5-1.5B
2.1 三条路
| 路线 | 代码改动 | 训练耗时 | 预期 0 分率 | 保留“从零构建”链路 |
|---|---|---|---|---|
| GPT-2 774M | 改一行 CHOOSE_MODEL |
~7 分钟 | 53% → 40~45% | ✅ |
| GPT-2 1.5B | 同上 | ~15 分钟 | ✅ | |
| Qwen2.5-1.5B base + LoRA | 新脚本 | ~4 分钟/epoch | 预计 <15% | ❌ |
选第三条的原因不是“新”,而是对照实验需要变量干净:GPT-2 774M 的容量翻倍了,但知识底子还是 2019 年 40GB WebText 那一套,花 40 分钟很可能只换来“0 分率从 53% 降到 43%”的边际改善;而 Qwen2.5 在 18T token 上预训练,知识是另一个量级,才能真正检验“底座决定上限”。
2.2 为什么用 base,不用 Instruct
这一点是实验设计的关键。如果直接拿 Instruct 模型来做 SFT,它出厂就已经会按指令回答,SFT 的效果会被掩盖——你分不清格式对齐是训练带来的还是本来就有。
所以对照组必须是未微调的 base:它知道“氯的元素符号是 Cl”,但不知道怎么“以回答问题的姿态”说出来。SFT 前后一对比,被改变的到底是什么,一目了然。
2.3 为什么不是最新的 Qwen3.8
写这篇时 Qwen 已经更新到 3.8 代,但 3.8 目前公开的是总参数 2.4T、激活 95B 的 MoE——本机 48GB 统一内存跑不动,那是 API 或云端推理的体量。能在 M4 Pro 上做 LoRA 消融的是小尺寸 base 版本;Qwen2.5-1.5B 的生态兼容性最稳,peft / transformers 踩坑最少。想用新一代也很简单——只改 MODEL_NAME,其余一行不动。
2.4 手搓的 GPTModel 去哪了
换到 HF 栈之后,第 4~6 章手写的 GPTModel、generate_text_util、train_model_simple_py 在新脚本里全部闲置了。不是白写——它们是读懂 HF 源码的坐标系:
| 我的实现(GPT-2 结构) | Qwen2.5 的结构 | 为什么变 |
|---|---|---|
tok_emb + pos_emb(可学习绝对位置) |
wte + RoPE(旋转位置编码) |
支持长度外推,context 1024 → 32k+ |
LayerNorm |
RMSNorm | 省去均值计算 |
GELU 两层 MLP(c_fc→c_proj) |
SwiGLU 三层(gate_proj/up_proj/down_proj) |
同参数量下效果更好 |
| MHA:12 个 Q 头 = 12 个 KV 头 | GQA:12 个 Q 头只配 2 个 KV 头 | 省 KV cache 显存——正好对上之前问的“为什么只有 KV cache” |
qkv_bias=True |
默认无 bias | 训练稳定性 |
| 词表 50257 | 词表 151936 | 多语言 |
真正被替换的只有三件:模型定义、生成函数、训练循环。被保留的是最值钱的部分——format_input 模板、InstructionDataset 的掩码思路、110 条测试集切分、判官打分流水线。实验之所以可比,靠的就是这些没动。
三、代码:ch07_qwen.py
3.1 训练侧:LoRA + 只对回答算 loss
模板和 GPT-2 版本逐字一致(format_input(entry) + "\n\n### Response:\n"),prompt 部分的 label 置 -100:
prompt = format_input(e) + "\n\n### Response:\n"
answer = e["output"] + tokenizer.eos_token
p_ids = tokenizer(prompt, add_special_tokens=False)["input_ids"]
a_ids = tokenizer(answer, add_special_tokens=False)["input_ids"]
ids    = (p_ids + a_ids)[:MAX_LEN]
labels = ([-100] * len(p_ids) + a_ids)[:MAX_LEN]
LoRA 挂在注意力与 MLP 的全部投影上(这是第一轮激进配置;文末的推荐配置是 r=8, α=16):
lora_config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,
    r=16, lora_alpha=32, lora_dropout=0.05,
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj",
                    "gate_proj", "up_proj", "down_proj"],
)
model = get_peft_model(model, lora_config)
# trainable params: 18,464,768 || all params: 1,562,179,072 || trainable%: 1.1820
1.18% 的参数可训练,其余 98.8% 冻结。优化器只接可训练参数:
optimizer = torch.optim.AdamW([p for p in model.parameters() if p.requires_grad], lr=LR)
一次优化 = 2 个 micro-batch(GRAD_ACCUM=2),loss = model(**batch).loss / 2 后 backward,每 2 步 step() 一次。
3.2 生成侧:HF 自带 KV cache
评估用的是 model.generate(..., max_new_tokens=128, do_sample=False)。和第 7 章手写的 generate 最大区别不是代码长短,而是 HF 的实现自带 KV cache:每生成一个 token 只算新位置,而不是把整个前缀重新 forward 一遍。110 条测试样本的完整评估因此从“不敢想”变成 1~2 分钟。
3.3 工程坑记录
- 模板多一个空格:
f"### Response: \n“比书上模板多一个空格,BPE 会多切出一个' 'token(id 220),loss 和抽取都和书对不上。改成”### Response:\n"后对齐。 allowed_max_length=1204:比context_length=1024还大,等于没截断;一旦样本超长,位置编码直接越界。改回 1024。num_workers=8+ macOS:Python 3.12 在 macOS 默认spawn,脚本顶层又没写if __name__ == "__main__",子进程重新 import 主模块导致无限套娃。改num_workers=0+ main guard 解决。- MPS 随机数独立:要复现就得同时
torch.manual_seed和torch.mps.manual_seed;计时要在末尾torch.mps.synchronize(),否则 GPU 队列还没排空。
四、评估协议:三个判据,两个口径
- 测试集:110 条,与 GPT-2 完全同一批。
- 判官:DeepSeek
deepseek-flash,temperature=0,输出 0–100 整数。 - 两种 prompt(这本身是第二组实验):
- 字面口径:按与参考答案的接近程度打分(和上一篇一致,可与 GPT-2 直接比较);
- 语义口径:只判事实/指令正确性,不判措辞、长度与格式。
- 三个无 API 成本的辅助指标:归一化 exact match、平均 token 数、128 token 截断数。判官会抖,客观指标不会。
prompt(语义口径):
You are grading a model answer. Judge ONLY factual/instructional correctness,
NOT wording, length, or format. A semantically equivalent answer is full marks.
...
Score 0-100. Respond with the integer only.
五、第一轮:base vs 激进 SFT —— 换底座赢麻了,SFT 白忙了
5.1 结果
字面口径(与 GPT-2 同口径):
| 组别 | 均分 | 中位 | 0 分率 | ≥80 占比 |
|---|---|---|---|---|
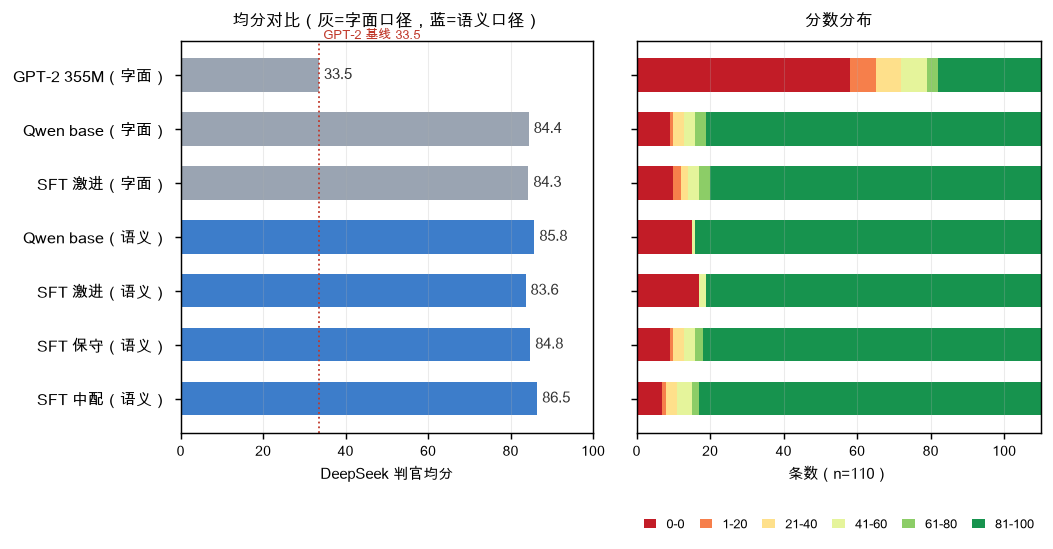
| GPT-2 355M + SFT | 33.5 | 0 | 52.7% | 25.5% |
| Qwen base | 84.4 | 100 | 8.2% | 82.7% |
| Qwen + SFT(激进) | 84.3 | 100 | 9.1% | 81.8% |
生成侧指标:
| 组别 | exact match | 平均 token | 截断 | 空回答 | 模板残留 |
|---|---|---|---|---|---|
| GPT-2 355M | 15.5% | 17.0 | 1 | 0 | 2 |
| Qwen base | 24.5% | 31.4 | 6 | 0 | 0 |
| Qwen SFT(激进) | 42.7% | 13.1 | 0 | 0 | 0 |
5.2 观察一:base 根本不需要“教知识”
未微调的 base 在同样的模板下,直接答对了这些题:
雷暴云类型      → cumulonimbus
氯的元素符号    → Cl
《傲慢与偏见》作者 → Jane Austen
上一轮 355M 答错的同一道 chlorine 题,base 没经过任何 SFT 就答对了。知识是预训练给的,这句话从“猜”变成了“看到”。
5.3 观察二:SFT 在强底座上几乎不提分,只改形状
字面口径下 base 84.4、SFT 84.3,逐条对比 110 条里有 91 条分数完全相同。但 SFT 明确改变了三件事:
- exact match 24.5% → 42.7%;
- 平均长度 31.4 → 13 token(base 爱写小作文,SFT 只给答案);
- 128 token 截断 6 条 → 0 条(base 会陷入「without my phone without my phone…」的复读,SFT 不会)。
base 的失败模式是“知道答案但话太多、停不下来”,SFT 修的正是这个。判官分不动,是因为它本来就答对了。
5.4 观察三:灾难性遗忘 —— SFT 把知识写坏了
这是这一轮最意外的发现。以“base 给 100 分、SFT 却 <60 分”定义知识回退,激进配置出现了 9 条(其中 8 条是真错,1 条是判官误判——列表式分类那道):
| 指令 | base | 激进 SFT |
|---|---|---|
| 二氧化碳分子式 | CO2 | C2O2 |
| 硫的沸点 | 444.6°C | 112°C |
| 判断句式(Did you…?) | question | imperative |
| 挑出形容词(run/tall/quickly) | tall | tall 和 quickly(副词) |
| 鲨鱼分类 | Fish | Reptiles |
| I am lost 的意大利语 | Sono perso | Ti sei perso(“你迷路了”) |
| see you later 的西班牙语 | hasta luego | Vuelva a verme tarde |
| 用 elucidate 造句 | 用了该词 | 句子没用 elucidate |
1100 条数据、lr=2e-4、2 个 epoch——模型为了贴合 Alpaca 的措辞,把预训练学的知识挤掉了。这就是灾难性遗忘(catastrophic forgetting)。
六、第二轮:把学习率降下来,知识真的回来了
直觉判断:遗忘是“更新太猛”造成的。把总更新幅度砍到 1/8:
LR = 5e-5        # 2e-4 → 5e-5
NUM_EPOCHS = 1   # 2 → 1
r=8, lora_alpha=16   # r=16, alpha=32 → r=8, alpha=16
结果:
| 条目 | base | 激进 | 保守(1ep/5e-5/r8) |
|---|---|---|---|
| CO2 分子式 | 100 | 0 | 100 |
| 硫沸点 | 100 | 0 | 90(444 vs 444.6) |
| 句式判断 | 100 | 0 | 85(「a question」) |
| 形容词 | 100 | 0 | 100 |
| I am lost 意语 | 85 | 0 | 90(Mi sono perso) |
| see you later 西语 | 100 | 0 | 100(hasta luego) |
| elucidate 造句 | 100 | 0 | 95(The professor elucidated…) |
| irony 定义 | 100 | 0 | 85 |
8 条全部修复。 语义口径均分 84.8,exact match 37.3%(比激进版低 5.4pp)。
结论升级:遗忘不是 SFT 的必然,是超参的选择。少训一点、慢一点,可以在“格式对齐”和“保住知识”之间找到平衡。
七、第三轮:找甜点 —— 1 epoch / 1e-4 / r=8
保守版把知识救回来了,但格式对齐退得有点多。把 lr 从 5e-5 提到 1e-4(总更新幅度仍是激进版的 1/4),再跑一轮:
| 指标 | 保守 5e-5 | 中配 1e-4 | 激进 2e-4×2 |
|---|---|---|---|
| exact match | 37.3% | 39.1% | 42.7% |
| 语义均分 | 84.8 | 86.5 | 83.6 |
| 0 分率 | 8.2% | 6.4% | 15.5% |
| 真实知识回退 | 3 条 | 2 条 | 8 条 |
中配还剩下 4 条“回退”,但其中 2 条是判官的锅(见下一节),真实错误只有“nostalgia 造句没用该词”和“鲨鱼被分类成爬行动物”两条。
这就是甜点:Qwen2.5-1.5B base + LoRA(r=8, α=16) + 1 epoch + lr 1e-4。
补充:为什么“回退条数”比均分更能说明问题
看配对统计会更清楚(语义口径,vs base):
| 对比 | 均分差 | 95% 置信区间 | 更好 | 更差 | 打平 |
|---|---|---|---|---|---|
| 激进 − base | −2.14 | [−9.3, +5.0] | 8 | 11 | 91 |
| 保守 − base | −1.00 | [−6.2, +4.2] | 10 | 37 | 63 |
| 中配 − base | +0.68 | [−4.7, +6.0] | 12 | 35 | 63 |
三个区间全部跨过 0——在这个已经很强的 base 上,SFT 对“判官均分”没有统计显著的影响。它产生的影响全部落在分布形状上:base 是“15 个 0 分 + 94 个 81–100 分”的极端两极化分布,中配把 0 分压到 7 条、把中间段补了 8 条。SFT 用“抹平少数满分”换来了“减少灾难性错误”。
八、第四次实验:评委自己也是变量
8.1 两种 prompt 的差别
同一个 base 模型、同一批回答,只换判官 prompt:
| 判官口径 | base 均分 | base 0 分率 |
|---|---|---|
| 字面 | 84.4 | 8.2% |
| 语义 | 85.8 | 13.6% |
语义 prompt 把 0 分率提高了——它让判官更“二元化”(要么 100、要么 0)。这说明 “改 prompt 以减少格式偏见” 这个预期没有完全实现,判官行为本身难以预测。
8.2 判官实锤误判的案例
- 列表式分类题:gold 是
Mercury - Liquid / Oxygen - Gas / Wood - Solid,SFT 答Solid: Wood / Liquid: Oxygen / Gas: Mercury——内容全对,被判 0。 - 德语翻译:
Badezimmer是 bathroom 的正确德语词之一,被判 0(gold 用Toilette)。 - 简洁的正确回答:base 用一整段解释得 100,SFT 一句话答对得 85——判官仍偏爱“长”。
8.3 波动有多大
- 同一份回复字面口径两次打分:84.2 / 84.4;
- 上一篇 GPT-2 记录 33.9 / 57 条 0 分,本次重算 33.5 / 58 条。
±0.5 分、±1 条 0 分是常态。 所以本篇所有结论都写“方向”和“区间”,不写“精确到小数点后一位的胜负”。
九、结论
- 底座决定上限,且是数量级的:同数据、同判官,GPT-2 355M 33.5 → Qwen2.5-1.5B 84
86。0 分率 52.7% → 613%。 - SFT 在强底座上是“塑形”不是“提分”:判官分无显著变化,但 exact match +14pp、回答长度腰斩、截断归零、极端错误减半。
- SFT 不是免费的:学习率/训练量过大会造成灾难性遗忘(CO2→C2O2、硫沸点 444.6→112);把更新幅度降到 1/8 后全部修复。“教格式”和“毁知识”之间只差一个学习率。
- 评估口径是结论的一部分:同一模型换判官 prompt,0 分率从 8.2% 变 13.6%;报告必须注明口径,并用 exact match 这类客观指标交叉验证。
- 推荐配置:
Qwen2.5-1.5B base + LoRA(r=8, α=16) + 1 epoch + lr 1e-4 + 只对 response 算 loss。
十、这篇笔记改掉的三句话
实验之外,这篇笔记还修正了我三个张口就来的认知,按被推翻的顺序记:
「一个差的模型,怎么微调都不会变强。」——不准确。355M 微调前后确实变了:会听指令、会吐结束符,「行为」变了;但知识问答照错,「能力」没动。准确的说法是:上限由预训练定死,后训练在上限之内调水位,水位的天花板是对齐数据的质量。alignment 便宜,capability 贵。
「SFT 反正是给模型加东西。」——错。SFT 不是免费的:激进配置把 CO2 教成 C2O2、把硫的沸点从 444.6°C 写成 112°C。教格式和毁知识之间只差一个学习率。「后训练决定平均答复水平」这句话要加半句——在训练数据配得上的前提下。
「国内模型是基础差、后训练厉害。」——也错,因果反了。真实剧情是算力受限逼出了全栈效率创新:MLA 压缩 KV cache(和 LoRA 同款的低秩思想,用在注意力上)、MoE 用稀疏换规模、FP8 砍精度换吞吐、GRPO 做后训练。不是后训练一层强,是三层都在拧毛巾。这个认知对我自己也有用:我的算力牌面比谁都紧,但约束不是借口,是设计的起点——nanochat 整个项目就是这个哲学。
顺带一个光谱观察:第六章「只解冻最后一块」、第七章「全参数微调」、本篇 LoRA「全冻结外挂低秩小路」——三种方案是同一个问题的三个答案:微调到底该动多少参数、动哪里。成本、效果、遗忘风险,三角取舍。
十一、模型仍然不会的题
两种口径下都 ≤20 分的 10 条,几乎全是变换类 / 开放创作类:
纠正标点        "Its time to go home." → 不会
替换陈词滥调     "It's very easy." → 不会
改为间接疑问句   → 不会
indefinite pronoun 转换 → 不会
幽默轶事创作     → 编的故事和“数学书为什么悲伤”无关
氯的沸点         -34°C → 不会
这是 1.5B 的能力边界,不是训练配置问题。Alpaca 里这类题的参考答案非常具体(「The corrected sentence should be: ‘It’s time to go home.’」),模型既不会做字符级编辑,也不会主动收束到那种格式。底座再大一号,这类题才会松动。
十二、留痕文件与复现
| 文件 | 内容 |
|---|---|
instruction-data-with-response.json / -scores.json |
GPT-2 355M 全参 SFT,字面口径 |
qwen-base-with-response.json / -scores.json / -scores-semantic.json |
Qwen base,两种口径 |
qwen-sft-with-response.json / -scores.json / -scores-semantic.json |
激进 LoRA(2ep/2e-4/r16) |
qwen-sft-lr5e5_ep1_r8-* |
保守 LoRA(1ep/5e-5/r8) |
qwen-sft-lr1e4_ep1_r8-* |
中配 LoRA(推荐) |
qwen2.5-1.5b-alpaca-lora{,-lr5e5_ep1_r8,-lr1e4_ep1_r8} |
三个 adapter |
硬件与耗时(M4 Pro / 48GB / MPS):GPT-2 355M 全参 2 epoch ≈ 2.85 分钟;Qwen LoRA 1 epoch ≈ 4 分钟;110 条生成评估 ≈ 1~1.7 分钟;110 条判官打分 ≈ 1.2 分钟。
十三、下一步
- 给中配补字面口径分数,把四组表补完整;
- 对 2 条真实回退和 10 条 both-low 各打 3 次取平均,压掉判官噪声;
- 换更能体现 SFT 价值的任务(JSON 输出、多轮对话、固定表格),避开这个数据集的天花板;
- 想再验证一次“底座决定上限”,可以换 Qwen3-1.7B-Base 重跑同一套脚本,只改
MODEL_NAME一行。
一句话总结
分数是评委给的,形状是训练给的,知识是预训练给的。
上一篇的 355M 让我看清了“后训练不是知识注入”;这一篇的 Qwen 让我看清了它的另一半——后训练也不是免费的,它能把知识挤走。这两句话合起来,才是 SFT 的完整画像。
评论