第五章是这本书到目前为止概念密度最高的一章:预训练、损失函数、训练循环、过拟合、解码策略、加载 GPT-2 权重。第一遍我学得很虚——手比脑快,一路照抄。离职后的回炉日,我用「考试 + A4 纸手写」把它重学了一遍。这篇笔记记的是第二遍的理解,以及第一遍踩过的坑。
一、训练到底在优化什么:512 张考卷
输入是 [a, b, c],target 是 [b, c, d]——错位一位,每个位置的 target 恰好是 input 同一位置的下一个 token。这就是 next-token 预测落到代码里的样子。
关键在数量级:一个 (2, 256) 的 batch,2 条序列 × 256 个位置 = 512 个独立的预测任务。logits.flatten(0, 1) 就是把这 512 张考卷摊平,一次 cross entropy 全判完。
这也解释了训练和推理的根本区别:
- 训练:一次前向,512 个位置并行判分,所有位置的输出全都要(所以输出形状是
(B, T, 50257)) - 推理:一个 token 一个 token 往外蹦,只需要最后一个位置的输出(
logits[:, -1, :])——因为前面位置的「答案」早就在输入里了,只有最后一个位置在预测真正未知的词
训练能并行的前提,是第三章的因果掩码:没有掩码,这 512 道题就全漏题了。掩码不只是「防止偷看」,它是让并行训练合法化的前提。
二、交叉熵:不是「差值」,是「正确答案的 log 概率取负」
我以前学机器学习,损失函数就是「预测值 − 目标值」。这个直觉在 LLM 里错了两次才拔掉:
logits 是 (6, 50257) 的矩阵,targets 是 (6,) 的 id 列表——矩阵怎么减一个 id? 根本没法减。真实的计算链是:
- 对每一行做 log_softmax(带 max 减法,后面讲)
- 用 target 的 id 做花式索引,取出正确 token 对应的 log 概率
- 取负、求平均 → 标量 loss
所以 loss 的准确说法是「模型给正确答案分配的概率,取 log 取负再求平均」。概率越大 → log p 越接近 0 → loss 越小。「最小化 loss」和「最大化正确答案的概率」是同一件事。 取负也不是数学必需,只是约定:全世界的优化器都按「最小化」设计,取负把「让 log p 上升」翻译成「让 loss 下降」。
为什么 argmax 不能进 loss
两个原因,缺一不可:
- 不可导。argmax 是阶跃操作,输入变一点,输出要么不变要么突变,导数几乎处处为 0。梯度流到它就断了,后面所有权重收不到任何更新信号。
- 丢失「距离」信息。正确答案概率 49%(排第二)和 0.001%(排一万名),对 argmax 来说都是「猜错」,loss 一模一样。但前者明明只差一口气——argmax 把「离正确答案有多近」这个最关键的信息扔掉了。cross entropy 用概率本身,模型每一点微小进步,loss 都看得见。
一句话:argmax 是推理时的选择器,不是训练时的指南针。
花式索引:每道题只取自己的分
probas[text_idx, [0, 1, 2], targets[text_idx]],probas 形状 (2, 3, 50257)。这句在做什么:取第一个序列三个位置、各自对应的正确 token 的概率,共 3 个值。
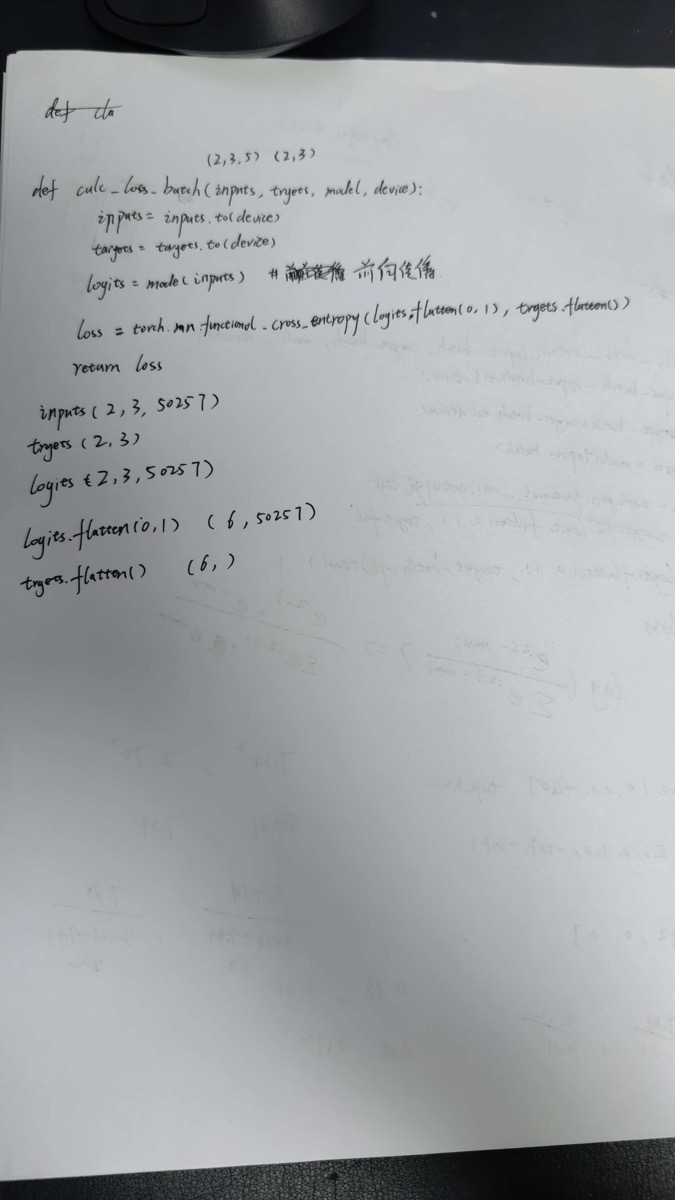
A4 手写稿:calc_loss_batch。inputs 那行一开始写成了 (2, 3, 50257),正确应为 (2, 3)——id 进,分布出。
三、max 减法:数学上不变,工程上救命
log_softmax 不直接算 log(exp(z_i) / Σexp(z_j)),而是先给所有 logits 减去行内最大值。
为什么结果不变? e^(z-c) = e^z × e^(-c),分子分母各提出一个 e^(-c),约掉。选谁当 c 都行,选 max 只是效果最好。
为什么必须减? float32 上限约 3.4×10³⁸,而 e^100 ≈ 2.7×10⁴³——装不下,直接溢出成 inf,后面全变 NaN。
减完之后的世界:行内所有值 ≤ 0,最大项恰好为 0。于是 exp(0) = 1 封住上限,其他项全在 (0, 1];分母至少是 1(最大项贡献了一个 1),log(分母) 永远不会碰到 log(0)。上溢下溢,一起消失。
四、过拟合:我的第一根训练曲线
第一次训练《The Verdict》(全文才 5145 个 token),10 个 epoch 下来:train loss 一路降到 0.391,val loss 第 2 轮触底后回升到 6.452。教科书级的过拟合现场:模型不是在学语言,是在背课文。early stopping 就该停在第 2 轮附近。
两个防过拟合的旋钮,机制完全不同:
| dropout | weight decay | |
|---|---|---|
| 动手对象 | 激活值(前向传播时) | 权重本身(参数更新时) |
| 手法 | 随机砍神经元,制造「残缺」 | 给大权重的解加「惩罚」 |
| 公式 | 保留的激活值 × 1/(1-p),期望不变 | w = w - lr×梯度 - (w × lr × wd) |
weight decay 我一开始错写成「减一个固定值」,纠正三次才懂:它是比例税不是人头税——合并成 (1 - lr × wd) × w 看得最清楚:每一步先把所有权重打个 0.99996 的折,再走正常的梯度下降。大权重被拽得狠,小权重几乎不动。权重小 = 函数平滑 = 想背课文都背不利索。
困惑度(PPL):把 loss 翻译成人话
PPL = e^loss,含义是「模型预测下一个词时,平均在多少个候选之间犹豫」:
| 模型状态 | loss | PPL | 含义 |
|---|---|---|---|
| 随机权重 | 10.76 | ~47,000 | ln(50257) ≈ 10.82,在整个词表里纯蒙 |
| 训 10 轮(train) | 0.391 | 1.48 | 背过的课文里只在 1.5 个词之间犹豫 |
| 训 10 轮(val) | 6.452 | ~635 | 没见过的文本上,还要在 635 个词里蒙 |
背到 PPL 1.48,泛化只有 PPL 635——过拟合用困惑度表达,就是这么赤裸。
五、生成策略:argmax 死循环与抽奖箱
第一版 generate_text_simple 用 argmax,第 1 轮训练后生成的是 and, and, and, and... 死循环。三环机制:
- 确定性:同一个前文,argmax 永远选同一个词
- 自回归反馈:选出的词拼回上下文,输出变成输入
- 自我强化:「and and and」进上下文后,模型更倾向于继续「and」——每一次重复都在给下一次重复投票
改进版流水线:logits → top_k 过滤 → 温度缩放 → softmax → multinomial 抽样。
- top_k 的本质:给采样划一个靠谱的候选池——next-token 不是唯一解,而是一个分布。全词表任意组合早就失去了句子的连贯性,top_k 把范围框在「都说得通」的前 k 名里:k=1 等价 argmax,k=50257 等于没筛。连贯和多样不是对立的,top_k 就是那个平衡点。手法是用第 k 名的分数当门槛,低于门槛的全部打成 -inf(和因果掩码同一手法,目的不同)
- 温度除的是 logits,不是概率。T < 1 = 放大差距 = 尖锐(T→0 退化成 argmax);T > 1 = 压缩差距 = 均衡(T→∞ 退化成均匀分布)。温度只改赔率,本身完全确定,没有随机性。和 top_k 的区别:温度调「池子里各候选的胜率」,top_k 定「池子的大小」
- multinomial 才是随机性进来的地方:按概率分布真实抽样。跑 1000 次,88% 的词大约出现 880 次——分布是赔率,抽样是开奖
- 光调温度救不了 argmax:z/T 是单调变换,不改变谁最大。温度只有在采样时才起作用
实测手感:同一个 GPT-2 权重、同一个 prompt,temperature=1.5 时模型开始胡说「3:50 method」这种不存在的东西;调低就通顺。多样性和靠谱度是一根滑杆的两端。
六、加载 GPT-2 权重:权重是序列化对象,架构是类定义
能加载 GPT-2 权重,是因为我的 GPTModel 严格按 GPT-2 的「类定义」写的:12 层、768 维、LayerNorm、学习式位置嵌入、GELU、12 头。权重文件只对同一个架构有效——字段名、顺序、shape,差一个都对不上。DeepSeek / Qwen 是另一套类定义(RMSNorm、RoPE、SwiGLU、GQA/MoE),直接灌必炸。
加载代码里的考点:
attn.c_attn把 Q、K、V 存在一个融合矩阵里,np.split(..., 3, axis=-1)切成三份——能合并的矩阵就合并,一次 GEMM 算完- 每个 weight 后面的
.T:GPT-2 原版是 TensorFlow,存(输入维, 输出维);PyTorch 的nn.Linear存(输出维, 输入维)。两家存储协议相反,灌之前必须转置 ff.layers[0]和ff.layers[2]:中间的 layers[1] 是 GELU,没有参数qkv_bias要改成 True:GPT-2 原版有偏置,配置不改连 bias 属性都不存在context_length要改回 1024:我训练时图快用 256,但权重的 wpe 是 (1024, 768),对不上就是 shape mismatch
最后一行藏着 124M 的秘密
gpt.out_head.weight = assign(gpt.out_head.weight, params["wte"])——输出层和词嵌入表共享同一张表。输入时按 id 查行(确定性索引),输出时拿隐状态和 50257 行逐个算点积(相似度打分):正向当字典用,反向当标尺用,词的含义只需要学一份。这就是 weight tying。如果 out_head 独立,要多出 50257 × 768 = 38,609,408 个参数——我的模型数出来 163M、论文写 124M,差的就是这一份。
同一个骨架,三个灵魂
| 权重来源 | 输入 Every effort moves you 之后 |
|---|---|
| 随机初始化 | 乱码:and, and, and... |
| 自己训 10 轮 | 王尔德文风的英文,但只会背《The Verdict》 |
| GPT-2 预训练权重 | 通顺、开放、有泛化能力的语言 |
架构决定能力的上限,权重决定能力的成色,数据决定灵魂的形状。
七、generate 的 shape 全链路
这是我今天收获最大的一张图。设定 B=1、prompt 3 个 token、V=50257、top_k=50:
idx: (1, 3)
  │ ① 截窗口 idx[:, -1024:]:序列还不长,(1, 3) 不动(防御性步骤)
  ▼
前向 model(idx_cond):(1, 3) → (1, 3, 50257),每个位置都有 50257 个分数
  │ ② 取最后一个位置 logits[:, -1, :]:(1, 3, 50257) → (1, 50257)
  │    整数索引,T 这一维直接被抽掉,不是 (1, 1, 50257)!
  ▼
③ top_k:top_logits, _ = topk(logits, k=50) → (1, 50),降序
   min_val = top_logits[:, -1] → (1,),第 50 名的分数当门槛
   torch.where(logits < min_val, -inf, logits) → (1, 50257) 形状不变
   ⚠ 门槛值必须用新变量接!覆盖原 logits 就把完整名单弄丢了
  ▼
④ 温度 / softmax:形状不变,50 个位置概率 > 0,其余为 0,总和为 1
  ▼
⑤ multinomial(probas, num_samples=1):(1, 50257) → (1, 1)
   (argmax 殊途同归:softmax 单调,取 logits 还是 probas 结果一样)
  ▼
⑥ cat((idx, idx_next), dim=1):(1, 3) + (1, 1) → (1, 4),回 ① 进入下一轮
整个 generate,形状真正变化的只有三处:前向升维(加 V)、取末位降维(去 T)、拼接长维(T+1)。其余操作全是「形状不动,内容在变」。
治「dim 总乱」的药方就一句:写 dim 之前先报一遍每一维的含义(B=第几条序列、T=第几个位置、V=词表)。softmax/argmax 在词之间比大小 → dim=-1;cat 接在序列后面 → dim=1。dim 不是背的,是推出来的。
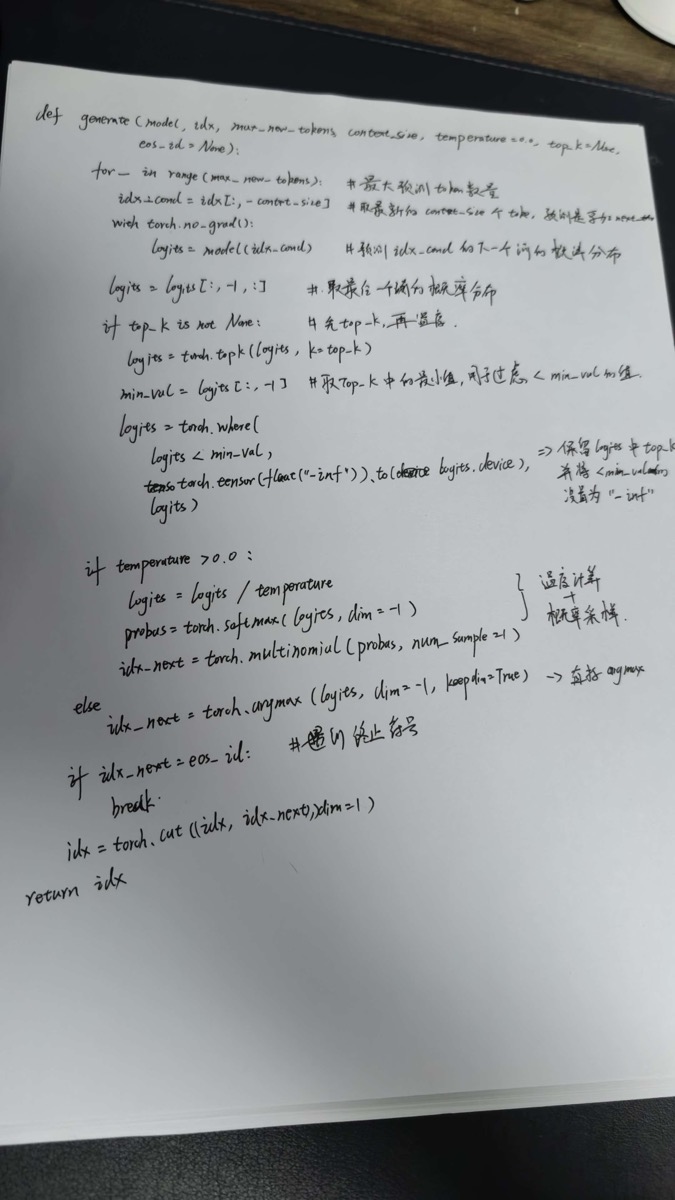
A4 手写稿:generate 全流程。纸上抓出三个实质 bug:topk 覆盖原名单、切片少冒号、= 与 ==。
八、device 教训:model.to(device) 只搬模型,不搬数据
在 MPS 上踩了两次同一族错误,规律钉死:
每一个后出生的张量,都要自己
.to(device)报到。
model.to(device) 只搬权重。text_to_token_ids 里 torch.tensor(encoded) 出生在 CPU,没人接它去 MPS,就会报 Passed CPU tensor to MPS op。排查顺序:顺着 traceback 找到最上层自己的代码 → 往前追输入张量的出生地 → 有没有送去 device。
第五章完。第六章:分类微调。
评论